Pipeline Automatizzata per l'Estrazione Documentale AI con n8n
Il Segnale
I team enterprise accumulano report di settore, ma nessuno li legge davvero poiché l'estrazione manuale richiede fino a un'ora per documento. Questo build log di ingegneria illustra nei dettagli una pipeline di ingestione automatizzata basata su n8n e PDF Vector. Il sistema riduce il tempo di elaborazione da 60 minuti a 20 secondi per singolo documento.
Il Cambio di Paradigma Architetturale
Il passaggio dalla revisione manuale dei documenti a una pipeline di estrazione AI automatizzata e parallelizzata rivoluziona la gestione della conoscenza aziendale. Trasforma archivi statici di file in feed attivi di intelligence operativa.
- Impatto sui Sistemi: Sostituisce la lettura isolata a livello locale con un database centralizzato e indicizzato su Google Sheets e notifiche broadcast automatizzate su Slack.
- Performance: Raggiunge una riduzione del 99,4% nel tempo di elaborazione, passando da 45-60 minuti ad appena 18-22 secondi per documento.
- Scalabilità: L'architettura di elaborazione parallela consente l'estrazione simultanea di dati strutturati e la generazione di executive summary senza generare colli di bottiglia.
- Accuratezza: Mantiene un'alta fedeltà con circa il 97% di accuratezza sui metadati e circa il 91% sull'estrazione dei risultati principali.
Pattern di Implementazione
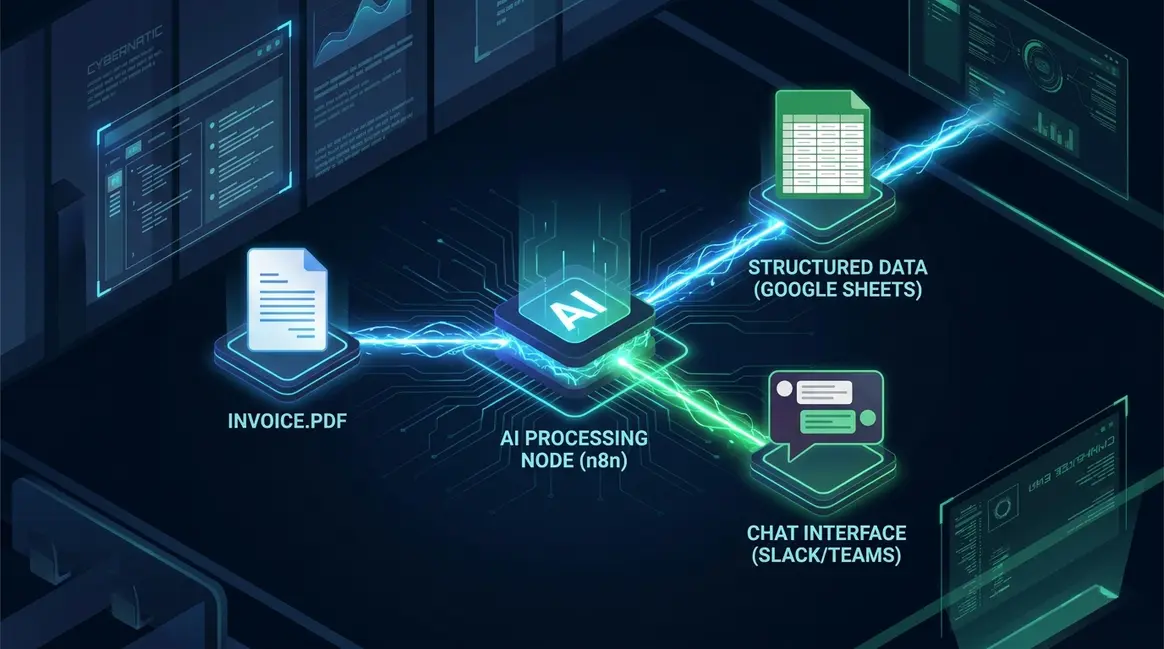
Il workflow opera su un'architettura event-driven innescata dal caricamento dei file. Ciò garantisce un'elaborazione zero-touch una volta completata la configurazione iniziale.
- Ingestione: Un trigger di Google Drive rileva i nuovi documenti caricati in una cartella designata.
- Elaborazione AI Parallela: Il documento viene instradato a PDF Vector per due passaggi simultanei: estrazione di dati strutturati e generazione dell'executive summary.
- Persistenza dei Dati: I dati strutturati estratti vengono aggiunti come nuova riga in una research library centralizzata su Google Sheets.
- Distribuzione: Un briefing formattato e ad alta leggibilità viene inviato a un canale Slack dedicato per una visibilità immediata da parte del team.
La Prospettiva del Fractional CTO
La market intelligence non letta rappresenta un puro costo sommerso (sunk cost). Automatizzando l'estrazione di insight azionabili, si convertono dati dormienti in leva operativa attiva. La riduzione dell'OPEX è drastica se si calcola la tariffa oraria di analisti o dirigenti che spendono 45 minuti per ogni report.
Inoltre, instradare segmenti specifici di intelligence a canali mirati accelera direttamente le attività generatrici di MRR. Ad esempio, la documentazione tecnica può essere inoltrata all'engineering, mentre le analisi di mercato possono alimentare direttamente la sales intelligence. Si tratta di un'automazione ad alto ROI che richiede una manutenzione minima.
Fonte Telemetria di Sistema: Report Ingegneristico Originale
Blueprint di Crescita Correlati
Tutti gli Esperimenti →Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.