Audit Automatizzati del Sito: Da Chromium Headless a BigQuery
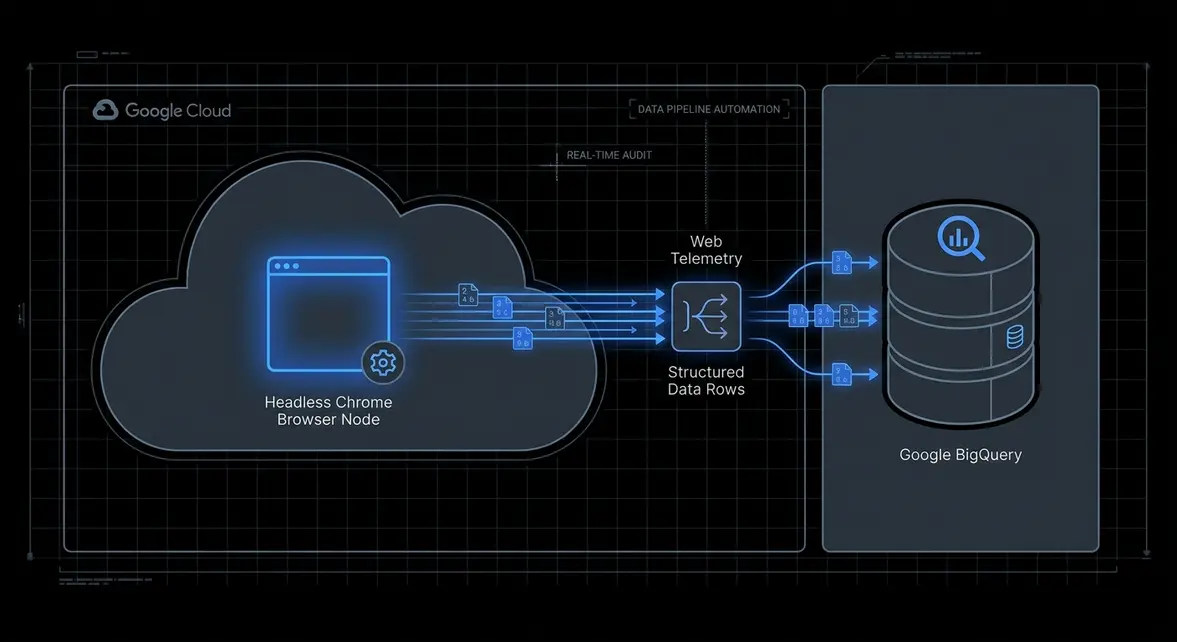
Pipeline Automatizzata di Scraping URL verso BigQuery tramite Chromium Headless
Takeaway Architetturale Esecutivo: I tradizionali crawler SEO desktop generano forte attrito operativo negli ambienti enterprise a causa di vincoli computazionali rigidi, costi di licenza per postazione e gestione manuale di file CSV. Disaccoppiare il runtime del crawler su Google Compute Engine o container serverless tramite Chromium headless, convogliando la telemetria direttamente in Google BigQuery, stabilisce una pipeline dati programmatica e persistente. Questa architettura intercetta derive di metadati, violazioni canoniche ed errori HTTP prima che compromettano l'equity organica del sito.
I flussi di lavoro di audit per il SEO tecnico convenzionali dipendono da software desktop ad-hoc o strumenti SaaS terzi rigidi che non si integrano nelle pipeline di continuous deployment (CI/CD). Quando i team di ingegneria rilasciano aggiornamenti programmatici al routing, modifiche allo shell di Single Page Application (SPA) o riscritture di URL basate su database, il ritardo tra il deployment e il rilevamento manuale supera spesso le settimane. Trattando gli audit SEO tecnici come test di integrazione automatizzati eseguiti su infrastruttura cloud, i team azzerano completamente questi ritardi.
Eseguire Chromium headless in ambiente cloud garantisce parità totale di rendering DOM con i bot moderni come Googlebot. Il crawler cattura gli stati HTML renderizzati lato client, esegue le routine di idratazione asincrona e analizza catene di reindirizzamento che le semplici richieste HTTP statiche non sono in grado di rilevare. Inviare questi dati a valle in BigQuery converte gli snapshot di audit frammentati in un data warehouse analitico append-only, pronto per il rilevamento automatico di anomalie e la visualizzazione su dashboard.
Infrastruttura SEO Tecnico: Estrazione DOM a Runtime vs Scraping Statico
Le moderne architetture web realizzate con framework come Next.js, Nuxt e Remix introducono l'idratazione dello stato lato client, rendendo inefficaci i crawler basati su semplici richieste HTTP GET. I crawler statici esaminano la risposta iniziale del server, che spesso contiene div segnaposto vuoti e tag title non popolati quando il client-side rendering presenta anomalie. L'utilizzo di un runtime Chromium headless assicura che l'audit valuti l'esatto DOM renderizzato esposto ai web crawler al completamento dell'esecuzione JavaScript.
Inviare i risultati di scansione direttamente in streaming su BigQuery trasforma la telemetria del sito in un data warehouse interrogabile, in cui gli ingegneri SEO possono eseguire query SQL diagnostiche ad altissima velocità. Partizionando le tabelle per crawl_timestamp e clusterizzandole per status_code e url_domain, i team possono calcolare delta strutturali giornalieri: identificando pagine orfane appena introdotte, nodi profondi non indicizzati e catene di redirect circolari su patrimoni da milioni di URL senza scansionare partizioni storiche ridondanti.
Questa acquisizione continua di dati protegge specificamente da vulnerabilità programmatiche di indicizzazione frequenti:
- Soft 404 Silenziosi: Rotte dinamiche lato client che mostrano una pagina di errore visiva restituendo contemporaneamente un codice di stato HTTP
200 OK. - Deriva Canonica: Discrepanze tra gli header canonici inviati dal server e i tag
<link rel="canonical">idratati dal client. - Decadimento dei Link Interni: Loop programmatici profondi in cui la navigazione a faccette dinamica genera trappole di scansione infinite, prosciugando il crawl budget.
- Anomalie di Parità dei Metadati: Stringhe di
document.titlee<meta name="description">vuote o segnaposto causate da timeout di idratazione o chiamate API fallite.
Runbook Ingegneristico di Produzione: Crawler Containerizzato & Ingestione BigQuery
Il deployment di un crawler automatizzato richiede due componenti tecnici fondamentali: uno schema di destinazione BigQuery ottimizzato e partizionato, e un processo di scansione Node.js asincrono basato su Chromium headless che esegue lo streaming in batch dei record tramite le API @google-cloud/bigquery.
In primo luogo, definisci la tabella di destinazione BigQuery utilizzando il partizionamento basato sul tempo di ingestione e il clustering per velocizzare le query sui delta:
CREATE TABLE `project_id.seo_telemetry.crawl_results` (
  crawl_timestamp TIMESTAMP,
  url STRING,
  status_code INT64,
  page_title STRING,
  meta_description STRING,
  canonical_url STRING,
  internal_outlinks ARRAY<STRING>,
  external_outlinks ARRAY<STRING>,
  load_duration_ms INT64
)
PARTITION BY DATE(crawl_timestamp)
CLUSTER BY status_code, url;
Successivamente, implementa la pipeline di scansione in Node.js. Questo script inizializza Puppeteer, attraversa ricorsivamente le rotte interne target, estrae i metadati dal DOM e invia i record a BigQuery tramite l'API di inserimento in streaming:
const puppeteer = require('puppeteer');
const { BigQuery } = require('@google-cloud/bigquery');

const bigquery = new BigQuery();
const DATASET_ID = 'seo_telemetry';
const TABLE_ID = 'crawl_results';

async function crawlAndStream(seedUrl, maxPages = 100) {
  const browser = await puppeteer.launch({
    headless: 'new',
    args: ['--no-sandbox', '--disable-setuid-sandbox']
  });

  const visited = new Set();
  const queue = [seedUrl];
  const domain = new URL(seedUrl).hostname;

  while (queue.length > 0 && visited.size < maxPages) {
    const currentUrl = queue.shift();
    if (visited.has(currentUrl)) continue;
    visited.add(currentUrl);

    const page = await browser.newPage();
    const startTime = Date.now();

    try {
      const response = await page.goto(currentUrl, { waitUntil: 'domcontentloaded', timeout: 30000 });
      const duration = Date.now() - startTime;
      const statusCode = response ? response.status() : 0;

      const pageData = await page.evaluate((currDomain) => {
        const title = document.querySelector('title') ? document.querySelector('title').innerText : '';
        const metaDesc = document.querySelector('meta[name="description"]')
          ? document.querySelector('meta[name="description"]').getAttribute('content') : '';
        const canonical = document.querySelector('link[rel="canonical"]')
          ? document.querySelector('link[rel="canonical"]').getAttribute('href') : '';

        const anchors = Array.from(document.querySelectorAll('a[href]'));
        const internal = [];
        const external = [];

        anchors.forEach(a => {
          try {
            const parsed = new URL(a.href);
            if (parsed.hostname === currDomain) {
              internal.push(parsed.origin + parsed.pathname);
            } else if (parsed.protocol.startsWith('http')) {
              external.push(a.href);
            }
          } catch (e) {}
        });

        return {
          title,
          metaDesc,
          canonical,
          internalOutlinks: [...new Set(internal)],
          externalOutlinks: [...new Set(external)]
        };
      }, domain);

      const row = {
        crawl_timestamp: new Date().toISOString(),
        url: currentUrl,
        status_code: statusCode,
        page_title: pageData.title,
        meta_description: pageData.metaDesc,
        canonical_url: pageData.canonical,
        internal_outlinks: pageData.internalOutlinks,
        external_outlinks: pageData.externalOutlinks,
        load_duration_ms: duration
      };

      await bigquery.dataset(DATASET_ID).table(TABLE_ID).insert([row]);

      for (const nextLink of pageData.internalOutlinks) {
        if (!visited.has(nextLink) && !queue.includes(nextLink)) {
          queue.push(nextLink);
        }
      }
    } catch (err) {
      console.error(`Fallimento esecuzione su ${currentUrl}:`, err.message);
    } finally {
      await page.close();
    }
  }

  await browser.close();
}

crawlAndStream('https://example.com', 500);
Accelerazione della Crescita Enterprise B2B & Ottimizzazione dei Margini
Per le organizzazioni B2B ad alta crescita che gestiscono superfici di acquisizione programmatiche — come cataloghi di integrazioni, glossari tecnici o directory clienti multi-tenant — l'igiene dei dati determina direttamente l'efficienza economica dell'acquisizione. Se un rilascio errato danneggia il routing di 15.000 pagine di directory, i motori di ricerca deindicizzano rapidamente i contenuti obsoleti, incrementando il Customer Acquisition Cost (CAC) organico mentre i team ricorrono a canali a pagamento per compensare la perdita di traffico.
Migrare gli audit tecnici su una pipeline dati proprietaria nel cloud offre due vantaggi immediati. In primo luogo, abbatte i costi di licenza dei software SaaS enterprise fino al 90%, sostituendo costosi abbonamenti a utente con job di calcolo economici su Compute Engine o Cloud Run (meno di $5,00 per 100.000 pagine). In secondo luogo, riduce i tempi di risoluzione abilitando la validazione immediata sulle pull request: crawler automatizzati possono essere eseguiti negli ambienti di staging prima del merge sul branch main, garantendo che nessun link interrotto o tag canonical mancante raggiunga mai gli indici dei motori di ricerca.
System Telemetry Source: Original Engineering Report
Blueprint di Crescita Correlati
Tutte le Guide →Vuoi applicare questo sistema nel tuo business?
Che tu gestisca un'azienda o un team marketing/tech, condividi il sito e il tuo collo di bottiglia: entro 48 ore ricevi un piano d'azione chiaro.