Modellazione dei parametri custom GA4 e architettura degli eventi
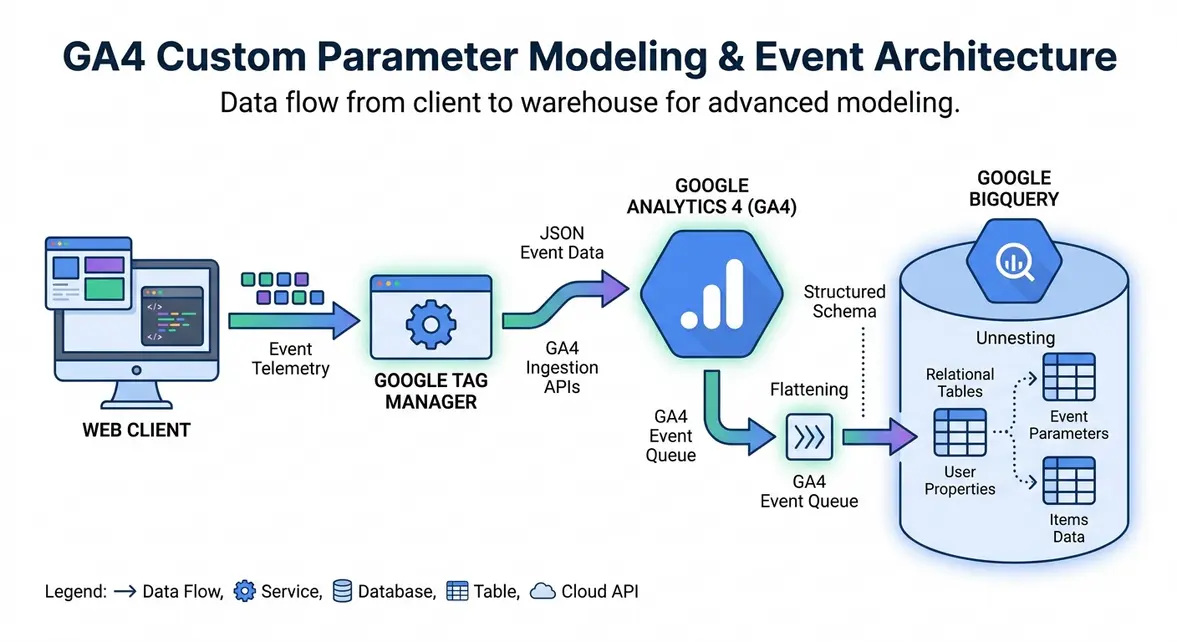
Decostruire gli schemi rigidi di Universal Analytics per l'ingestione Event-Driven
L'architettura legacy di Google Universal Analytics (UA) costringeva il tracciamento degli eventi all'interno di una tassonomia rigida a quattro dimensioni: Category, Action, Label e Value. Questo vincolo gerarchico portava frequentemente i growth engineer a serializzare attributi di metadati distinti in stringhe delimitate da pipe all'interno del campo Label, creando colli di bottiglia critici nel parsing dei dati nelle piattaforme analitiche a valle. Il paradigma di Google Analytics 4 (originariamente App + Web) sostituisce le gerarchie a livello di hit con uno schema unificato ed event-driven in cui ogni azione dell'utente è un'entità indipendente arricchita da coppie chiave-valore arbitrarie denominate parametri di evento.
Sebbene questo disaccoppiamento offra flessibilità programmatica, introduce un'architettura di reporting a doppio layer. L'invio di un parametro chiave-valore tramite il Google tag (gtag.js) o un container client-side di Google Tag Manager non rende automaticamente visibile quella variabile nell'esploratore di report dell'interfaccia utente nativa di GA4. Per visualizzare questi parametri nelle interfacce di esplorazione standard, i data engineer devono registrare definizioni di dimensioni personalizzate che collegano le chiavi dei parametri a runtime con gli slot dello schema interno. Al contrario, i parametri non indicizzati aggirano la pipeline di aggregazione standard dell'interfaccia utente ma rimangono costantemente interrogabili negli export raw in streaming su BigQuery, eliminando la frammentazione degli hit tipica dell'era UA.
Technical SEO, segnali di indicizzazione e architettura dei dati analytics
Il deployment di parametri di evento granulari impatta direttamente la technical SEO e la telemetria della digital experience. Anziché mantenere sistemi di tracciamento disgiunti per la telemetria di ricerca e la product analytics, i team tecnici possono convogliare metriche di Core Web Vitals, contesti di crawling/rendering e flag di indicizzazione all'interno di un unico payload client di analytics. Nelle Single Page Application (Next.js, Remix, Nuxt), questa architettura abilita l'invio programmatico delle variazioni di rotta insieme ai metadati di mutazione del DOM, evitando l'elevato overhead di payload derivante dall'attivazione di visualizzazioni di pagina UA complete sulle navigazioni virtuali.
Comprendere i vincoli dei parametri e i meccanismi di storage è essenziale quando si struttura una pipeline di acquisition enterprise:
- Gestione dell'alta cardinalità: Le proprietà standard impongono un limite di 50 dimensioni personalizzate con scope Event e 25 dimensioni con scope User. La registrazione di identificatori dinamici (es. UUID raw o timestamp ad alta entropia) come dimensioni standard dell'interfaccia innesca aggregazioni automatiche di soglia con etichetta (other). I valori raw ad alta cardinalità devono essere interrogati direttamente da BigQuery anziché mappati nell'interfaccia di GA4.
- Unnesting di payload complessi: I parametri di GA4 vengono esportati su Google BigQuery come record ripetuti:
event_paramscontenentikey,value.string_value,value.int_value,value.float_valueevalue.double_value. Il parsing SQL richiede cross-join espliciti e operazioni di unnest per ricostruire tabelle relazionali. - Isolamento della latenza delle sub-risorse: I payload dei parametri devono essere gestiti in modo asincrono tramite API browser non bloccanti (es.
Navigator.sendBeacon) per garantire che la raccolta delle metriche non competa con il main thread durante i cicli di rendering di Largest Contentful Paint (LCP) e Interaction to Next Paint (INP).
Implementazione Marketing Ops: Dal dispatch client all'estrazione in BigQuery
Per acquisire e interrogare i parametri personalizzati, il team di ingegneria deve implementare un protocollo di dispatch pulito a runtime, registrare lo schema dei parametri ed estrarre i dati non aggregati a valle. Di seguito è riportato il pattern di implementazione esatto per tracciare il coinvolgimento organico ad alto intento e interrogare lo schema in BigQuery.
Innanzitutto, invia un payload evento standardizzato al dataLayer di GTM utilizzando parametri tipizzati sulle landing page SEO strategiche:
window.dataLayer = window.dataLayer || [];
window.dataLayer.push({
  event: 'editorial_engagement',
  content_metadata: {
    cluster: 'technical-seo',
    word_count: 2450,
    reading_depth_percentage: 75,
    content_id: 'seo_arch_1092'
  }
});
All'interno di Google Tag Manager, configura una variabile di tipo Data Layer Variable che fa riferimento a content_metadata.cluster. Se mappi i parametri in variabili dinamiche, assicurati che token come {'{{DLV - Content Cluster}}'} corrispondano direttamente al nome del parametro personalizzato all'interno del tuo tag evento GA4.
Una volta inviato, il parametro deve essere estratto tramite Google BigQuery per aggirare il campionamento dell'interfaccia utente ed esplorare l'esatta correlazione tra i percorsi di acquisizione enterprise:
SELECT
  event_date,
  event_timestamp,
  event_name,
  (SELECT value.string_value FROM UNNEST(event_params) WHERE key = 'cluster') AS content_cluster,
  (SELECT value.int_value FROM UNNEST(event_params) WHERE key = 'reading_depth_percentage') AS depth_pct,
  user_pseudo_id
FROM
  `project_id.analytics_123456789.events_*`
-- In production, replace project_id and dataset table suffix
WHERE
  event_name = 'editorial_engagement'
  AND _TABLE_SUFFIX BETWEEN '20240101' AND '20240131'
LIMIT 1000;
B2B Growth e leva sull'MRR: Modellazione dell'attribuzione della pipeline
L'attribuzione standard basata sull'ultimo clic attribuisce frequentemente la creazione di pipeline B2B a conversioni generiche dirette o da ricerca branded, oscurando gli specifici articoli tecnici che hanno guidato la valutazione iniziale del prodotto. Parametrizzando il consumo dei contenuti di top-of-funnel—catturando attributi come content_cluster, code_snippet_copied e api_spec_downloaded—i growth team possono unire la telemetria anonima del client con i record di contatto del CRM in BigQuery in seguito alla sottomissione di un form di richiesta demo.
La correlazione dei parametri di contenuto personalizzati con le fasi di opportunità del CRM isola gli esatti cluster di contenuti organici che producono velocità nella pipeline. Ad esempio, le aziende di infrastruttura enterprise che utilizzano questo schema possono determinare che i prospect che consumano contenuti contrassegnati con cluster: 'kubernetes-architecture' generano un Average Contract Value (ACV) 3,4 volte superiore rispetto al traffico standard di panoramica prodotto, riducendo al tempo stesso il Costo di Acquisizione Clienti (CAC) del 18% grazie alla dismissione delle iniziative editoriali che non convertono.
Fonte Telemetria di Sistema: Report di Ingegneria Originale
Blueprint di Crescita Correlati
Tutte le Guide →Tracciare i Core Web Vitals in GA4 tramite Google Tag Manager
Real User Monitoring (RUM)
Configurare le variabili di impostazione di GA4 in GTM per la scalabilità dei dati
Disaccoppiamento Deterministico della Configurazione dei Tag
Vuoi applicare questo sistema nel tuo business?
Che tu gestisca un'azienda o un team marketing/tech, condividi il sito e il tuo collo di bottiglia: entro 48 ore ricevi un piano d'azione chiaro.