Architettura dei Dati Strutturati per la Ricerca AI
Il Fallimento dei Dati Strutturati nei Sistemi AI Basati su Retrieval-Augmented Generation
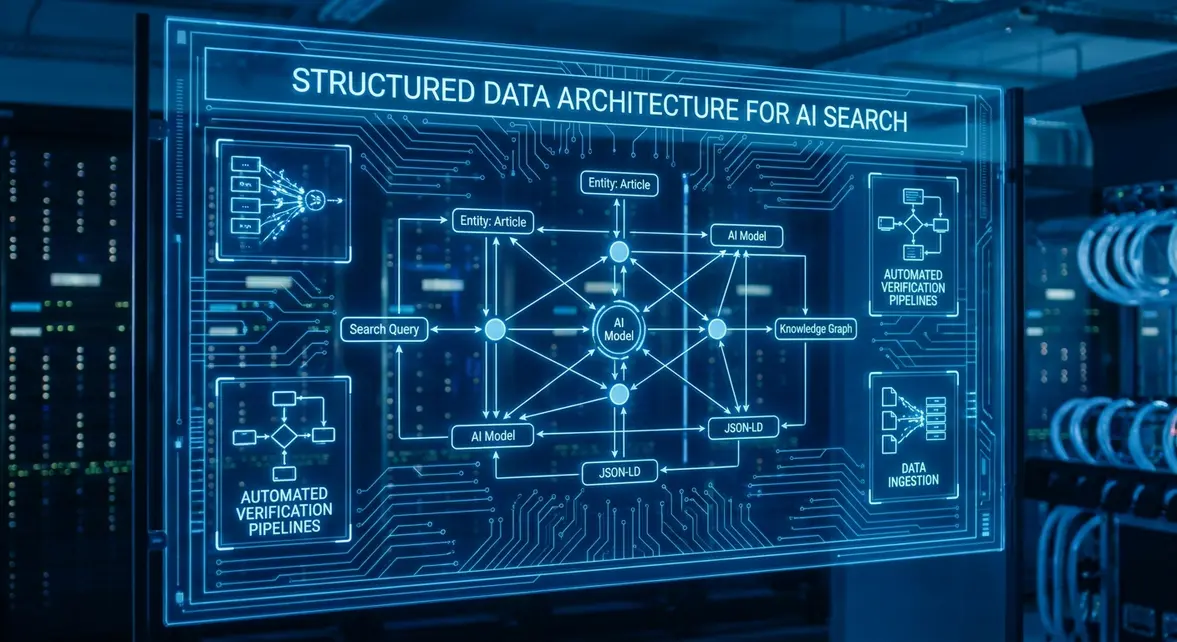
I motori Retrieval-Augmented Generation (RAG) alla base di strumenti come Google AI Overviews, Perplexity e OpenAI SearchGPT consumano il markup strutturato in modo radicalmente diverso rispetto ai tradizionali crawler dei motori di ricerca. I workflow SEO storici consideravano i dati strutturati come un meccanismo per ottenere rich snippet quali stelline di recensione o accordion FAQ. Al contrario, le moderne pipeline di ricerca AI utilizzano i nodi JSON-LD per costruire triple fattuali (Soggetto-Predicato-Oggetto) ad alta confidenza per il grounding delle entità. Quando un crawler analizza un blocco ambiguo di testo HTML, il livello strutturato funge da fonte definitiva di verità per gli embedding vettoriali e l'ingestione nel knowledge graph.
L'errore primario che determina la perdita di visibilità nell'AI è l'ambiguità semantica causata da schemi frammentati. Quando i team implementano blocchi di schema indipendenti e non collegati all'interno della stessa URL — come un nodo Organization isolato affiancato da un nodo Product scollegato — il parser semantico non riesce a mappare le relazioni dirette. I sistemi AI richiedono relazioni deterministiche. Senza un nodo radice @graph esplicitamente definito che colleghi le entità tramite URI @id stabili, i parser AI scartano i fatti a bassa confidenza, escludendo il dominio dalle risposte generative.
Disambiguazione delle Entità e Architettura a Grafo Annidato
I modelli di ricerca AI danno priorità alla certezza rispetto all'inferenza. Per ingerire e citare accuratamente i contenuti strutturati di una pagina, la pipeline di parsing del crawler deve risolvere l'entità rispetto a knowledge base consolidate (come Wikidata e Google Knowledge Graph). Se il payload strutturato è privo di primitive esplicite di disambiguazione dell'entità, il modello di ingestione rischia di confondere il tuo prodotto SaaS enterprise con terminologia di settore generica.
Per superare questo collo di bottiglia architetturale, i dati strutturati devono evolversi da markup di singola pagina a un enterprise graph completamente interconnesso. Questa configurazione elimina tre punti critici di fallimento:
- Contraddizione del Contenuto: Le incongruenze tra il testo renderizzato nel DOM e le proprietà JSON-LD innescano filtri di mitigazione delle allucinazioni negli algoritmi di retrieval dell'AI, con conseguente soppressione dalle AI Overview.
- Entità Non Ancorate: L'assenza di array
sameAsche collegano a URI autorevoli di entità (Wikidata, Crunchbase) costringe gli LLM a ipotizzare l'autorità dell'organizzazione. - Frammentazione dei Nodi: Molteplici tag
<script type="application/ld+json">disconnessi costringono il parser a un costoso processo di stitching del grafo, aumentando l'overhead di token e la latenza di indicizzazione.
Adottando una struttura @graph interconnessa, ogni entità presente sulla pagina — dall'autore principale ai dettagli dell'architettura software — si riconduce a un singolo nodo. Ciò garantisce ai parser di estrazione un accesso diretto a fatti verificabili e citabili.
Pipeline Automatizzata di Serializzazione e Validazione JSON-LD
Implementare dati strutturati in grado di superare le pipeline di estrazione AI richiede di superare i campi statici dei CMS tradizionali e migrare verso una generazione JSON-LD tipizzata e convalidata a tempo di build. L'utilizzo di definizioni TypeScript allineate alle specifiche di Schema.org assicura che ogni campo rispetti i tipi previsti prima dell'idratazione dell'HTML.
Di seguito è riportata un'implementazione Next.js enterprise che illustra come strutturare un payload @graph interconnesso contenente nodi per un'organizzazione, un'applicazione software e una valutazione tecnica all'interno dell'esecuzione server-side:
import Head from 'next/head';

interface SoftwareSchemaProps {
  appName: string;
  appUrl: string;
  pricing: string;
  orgName: string;
  orgWikidataUrl: string;
}

export function StructuredDataGraph({ appName, appUrl, pricing, orgName, orgWikidataUrl }: SoftwareSchemaProps) {
  const structuredData = {
    "@context": "https://schema.org",
    "@graph": [
      {
        "@type": "Organization",
        "@id": `${appUrl}#organization`,
        "name": orgName,
        "url": appUrl,
        "sameAs": [
          orgWikidataUrl
        ]
      },
      {
        "@type": "SoftwareApplication",
        "@id": `${appUrl}#software`,
        "name": appName,
        "applicationCategory": "BusinessApplication",
        "operatingSystem": "Web",
        "publisher": {
          "@id": `${appUrl}#organization`
        },
        "offers": {
          "@type": "Offer",
          "price": pricing,
          "priceCurrency": "USD"
        }
      }
    ]
  };

  return (
    <Head>
      <script
        type="application/ld+json"
        dangerouslySetInnerHTML={{ __html: JSON.stringify(structuredData) }}
      />
    </Head>
  );
}
Per impedire che dati non validi raggiungano la produzione, i team devono eseguire verifiche di continuous integration utilizzando strumenti come la Google Search Console API o script personalizzati di convalida dei nodi rispetto al vocabolario di Schema.org. Se un contratto dati cambia, la pipeline di CI/CD segnala la build prima che gli indicizzatori dei motori di ricerca riscontrino proprietà non conformi.
Espandere la Pipeline B2B e Ridurre il CAC tramite l'Ottimizzazione per i Motori AI
Nel procurement di software B2B, i buyer evitano sempre più i classici motori di ricerca a link blu per interrogare direttamente gli strumenti AI con requisiti operativi articolati: "Quali strumenti di fatturazione enterprise supportano il riconoscimento automatico dei ricavi ASC 606 e si integrano nativamente con Snowflake?" Quando i motori di recupero analizzano il web per sintetizzare le risposte, si affidano a nodi strutturati SoftwareApplication e TechArticle per verificare le funzionalità aziendali senza dover analizzare componenti UI imprevedibili.
Implementare architetture di schema interconnesse incide direttamente sul Costo di Acquisizione Clienti (CAC). Ottenendo citazioni dirette e inclusioni nelle AI Overview, i vendor B2B intercettano buyer ad alto intento durante le fasi di valutazione, aggirando la costosa competizione della ricerca a pagamento convenzionale. Le implementazioni enterprise che risanano schemi disconnessi registrano tipicamente risultati misurabili entro 60 giorni: un incremento del +34% nelle impression di ricerca generativa e una contrazione del 22% del CAC blended grazie alla crescita delle query organiche inbound generate dalle citazioni algoritmiche.
Fonte Telemetria di Sistema: Report di Ingegneria Originale
Blueprint di Crescita Correlati
Tutti gli Esperimenti →Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.