SEO Split Testing: Inferenza Causale & Controlli Edge
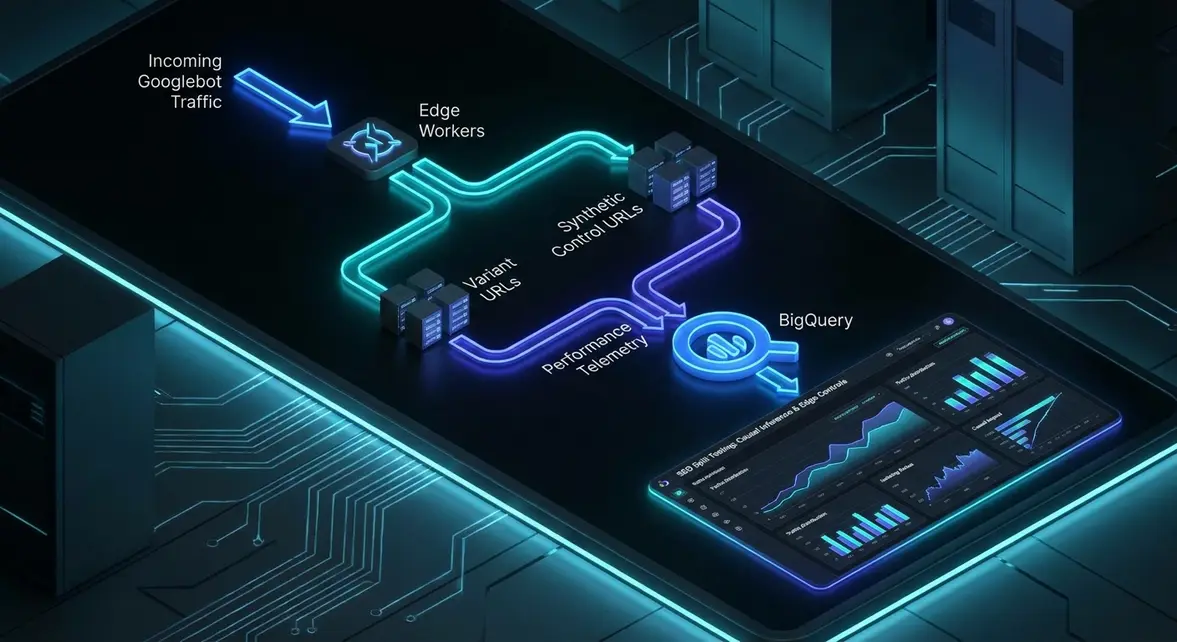
Inferenza Causale nella SEO Enterprise: Rimuovere il Bias da Drift Algoritmico con i Controlli Sintetici
Executive Architectural Takeaway: Affidarsi a semplici metriche di traffico organico prima-e-dopo introduce gravi errori di attribuzione dovuti a variazioni algoritmiche non modellate, fluttuazioni del crawl rate e stagionalità di mercato di base. Un SEO split testing di livello production richiede gruppi di controllo sintetici valutati tramite Bayesian Structural Time Series (BSTS) sui dati bulk export di Google Search Console. Questa architettura isola le modifiche reali di codice e schema dalla volatilità macro dell'ecosistema di ricerca, fornendo significatività statistica difendibile alla leadership growth.
La sperimentazione SEO legacy si basa pesantemente su confronti cronologici—misurando un set di URL modificati 30 giorni prima rispetto a 30 giorni dopo un deployment. Questa metodologia fallisce completamente in ecosistemi di ricerca volatili dove core update di Google, link velocity dei competitor e ri-classificazioni automatiche della qualità distorcono continuamente la baseline. Senza una baseline controfattuale simultanea e matematicamente abbinata, i team tecnici attribuiscono falsamente a modifiche minime di tag incrementi organici guidati dalla crescita della domanda di categoria, oppure annullano interventi strutturali efficaci perché un aggiornamento simultaneo del motore di ricerca ha compresso le impression globali del sito.
La moderna growth engineering richiede metodologie a controllo sintetico derivate dall'inferenza causale econometrica. Invece di dividere le sessioni utente (impossibile con i crawler dei motori di ricerca), gli ingegneri devono raggruppare insiemi di pagine strutturalmente omogenee—come route programmatiche di directory, schede prodotto o hub di documentazione—in coorti bilanciate di controllo e variante. Stabilendo pesi di regressione dinamici su migliaia di pagine di controllo invarianti, le data pipeline sintetizzano una curva controfattuale virtuale che rispecchia esattamente le performance attese del cluster variante in assenza di deployment.
Edge Routing e Meccaniche di Indicizzazione: Architettura di Page Clustering Server-Side
Le piattaforme di A/B testing client-side come Optimizely o VWO sono strutturalmente inadatte alla sperimentazione SEO tecnica. Iniettare modifiche DOM tramite JavaScript lato client provoca gravi Cumulative Layout Shift (CLS), peggiora il Largest Contentful Paint (LCP) e porta frequentemente Googlebot a indicizzare lo stato di fallback pre-iniezione a causa dell'esecuzione differita del Web Rendering Service (WRS). Per garantire che i crawler incontrino alberi DOM identici agli utenti reali senza rischiare penalizzazioni per cloaking, lo split testing deve essere eseguito interamente server-side al layer CDN o reverse-proxy edge.
Le piattaforme di esecuzione edge—come Cloudflare Workers, Fastly Compute o Next.js App Router Middleware—valutano i path delle richieste in ingresso rispetto a un manifest deterministico di clustering. Quando Googlebot o un utente finale richiede un URL target, l'edge worker verifica se la specifica entità appartiene al set di controllo o variante. La modifica della variante (come schema markup ottimizzato, gerarchie header alterate o moduli di internal linking) viene applicata prima dello streaming della risposta HTML verso il client. Questa architettura garantisce un delta TTFB inferiore a 10ms e mantiene una consegna DOM uniforme sia per crawler HTTP sia per motori browser.
Preservare una rigorosa parità per i motori di ricerca richiede invarianti strutturali assolute tra le partizioni delle coorti:
- Integrità del Canonical: Ogni pagina sia nel gruppo di controllo sia nel gruppo variante deve mantenere un tag self-canonical. Non utilizzare mai canonical incrociati tra gruppi per eseguire split test, poiché ciò segnala esplicitamente il consolidamento di contenuti duplicati e invalida la frequenza di crawl.
- Bilanciamento dei Link Interni: I moduli automatici di internal linking non devono sbilanciare il gruppo variante. Una distribuzione invariante del PageRank interno va imposta su tutte le coorti di test per evitare di confondere l'equity dei link con le modifiche tecniche on-page.
- Normalizzazione della Crawl Velocity: Monitora i log di accesso al layer edge in tempo reale per verificare che la distribuzione delle richieste di crawl di Googlebot resti proporzionale tra bucket di controllo e variante dopo il deployment.
Runbook di Produzione: Costruire un Motore Automatizzato di SEO Split Testing con BigQuery ed Edge Worker
Esegui la seguente pipeline per costruire un framework automatizzato e instradato all'edge di sperimentazione SEO supportato dalla telemetria bulk export di Search Console in BigQuery.
Step 1: Acquisisci e Abbina le Coorti di Controllo Sintetico
Esegui questo script SQL su BigQuery per aggregare la telemetria baseline (periodo pre-intervento) lungo le coorti di URL candidate, calcolando medie mobili per estrarre coppie abbinate con distribuzioni identiche di click e impression.
WITH PreInterventionMetrics AS (
  SELECT
    data_date,
    url,
    SUM(impressions) AS daily_impressions,
    SUM(clicks) AS daily_clicks,
    SAFE_DIVIDE(SUM(clicks), SUM(impressions)) AS daily_ctr
  FROM
    `enterprise-analytics.searchconsole.searchdata_url_impression`
  WHERE
    data_date BETWEEN DATE_SUB(CURRENT_DATE(), INTERVAL 60 DAY)
                  AND DATE_SUB(CURRENT_DATE(), INTERVAL 30 DAY)
    AND url LIKE 'https://example.com/integrations/%'
  GROUP BY
    1, 2
),
URLBaselines AS (
  SELECT
    url,
    AVG(daily_impressions) AS mean_impressions,
    STDDEV(daily_impressions) AS std_impressions,
    AVG(daily_clicks) AS mean_clicks,
    COUNT(DISTINCT data_date) AS active_days
  FROM
    PreInterventionMetrics
  GROUP BY
    1
  HAVING
    active_days >= 28
)
SELECT
  url,
  mean_impressions,
  mean_clicks,
  NTILE(2) OVER(ORDER BY mean_impressions DESC, mean_clicks DESC) AS assigned_cohort
FROM
  URLBaselines;
Step 2: Distribuisci l'Edge Routing Worker per l'Iniezione della Variante
Distribuisci un interceptor Cloudflare Worker mirato alla directory /integrations/*. Questo script legge il manifest di sperimentazione compilato dallo storage KV, inietta JSON-LD schema modificato nello stream HTML sulle pagine variante ed emette header di sperimentazione per la raccolta telemetrica a valle.
import { HTMLRewriter } from '@cloudflare/workers-types';

interface Env {
  EXPERIMENT_MANIFEST: KVNamespace;
}

export default {
  async fetch(request: Request, env: Env): Promise<Response> {
    const url = new URL(request.url);
    const pathname = url.pathname;

    // Verify cohort classification from Edge KV
    const cohort = await env.EXPERIMENT_MANIFEST.get(pathname);

    const response = await fetch(request);

    // Pass-through control group or unassigned paths
    if (cohort !== 'variant') {
      const newHeaders = new Headers(response.headers);
      newHeaders.set('X-SEO-Experiment', 'control');
      return new Response(response.body, {
        status: response.status,
        headers: newHeaders,
      });
    }

    // Inject upgraded SoftwareApplication JSON-LD into Variant HTML
    const rewriter = new HTMLRewriter().on('head', {
      element(element) {
        const schema = {
          '@context': 'https://schema.org',
          '@type': 'SoftwareApplication',
          'operatingSystem': 'Cloud',
          'applicationCategory': 'BusinessApplication'
        };
        element.append(
          `<script type="application/ld+json">${JSON.stringify(schema)}</script>`,
          { html: true }
        );
      }
    });

    const transformedResponse = rewriter.transform(response);
    transformedResponse.headers.set('X-SEO-Experiment', 'variant');
    return transformedResponse;
  }
};
Step 3: Calcola l'Uplift Controfattuale
Dopo una finestra di intervento di 30 giorni, estrai i totali giornalieri di impression per i gruppi di controllo e variante. Esegui la libreria R o Python CausalImpact tramite campionamento Markov Chain Monte Carlo (MCMC). Il gruppo di controllo funge da covariata predittiva per generare la proiezione controfattuale, restituendo il lift assoluto, il lift percentuale relativo e la probabilità a posteriori che il guadagno osservato sia statisticamente distinto dal rumore dell'ipotesi nulla (p < 0.05).
Impatto sul MRR Enterprise: Ridurre il Rischio della Programmatic SEO e Abbassare il CAC Blended
Distribuire modifiche incontrollate ai template su centinaia di migliaia di landing page programmatiche comporta un rischio finanziario enorme per le organizzazioni B2B enterprise. Una struttura di internal linking difettosa o un roll-out errato dei dati strutturati può innescare una penalizzazione algoritmica a livello di dominio, deteriorando direttamente la visibilità organica ad alto intento e facendo crollare la generazione di pipeline. Eseguendo esperimenti a controllo sintetico pilotati all'edge sul 5% delle sotto-directory candidate, i team di engineering validano se le modifiche tecniche aumentano l'efficienza di crawl e il volume di conversioni prima del rilascio globale, proteggendo milioni di Annual Recurring Revenue (ARR) attribuito all'organico.
Inoltre, un SEO split testing statisticamente rigoroso elimina la dipendenza dall'arbitraggio sulla ricerca a pagamento. Isolando i veri driver di ranking organico, i team di acquisizione ottimizzano sistematicamente i template delle landing page ad alta conversione per superare gli aggregatori concorrenti senza sprecare cicli di engineering su tattiche neutre o negative. Collegando direttamente i cluster variante ai dati di pipeline—tramite pipeline di tracciamento server-side attraverso GA4 Measurement Protocol e BigQuery—i growth leader calcolano l'esatta riduzione del CAC ottenuta per singolo test algoritmico, trasformando il backlog SEO in una product roadmap empirica generatrice di ricavi.
Fonte Telemetrica di Sistema: Report Tecnico Originale
Blueprint di Crescita Correlati
Tutte le Guide →Vuoi applicare questo sistema nel tuo business?
Che tu gestisca un'azienda o un team marketing/tech, condividi il sito e il tuo collo di bottiglia: entro 48 ore ricevi un piano d'azione chiaro.