Architettare pipeline di AI code review zero-touch: Automatizzare i feedback sulle PR con regole LLM personalizzate
La capacità ingegneristica è la risorsa più costosa e al contempo più sprecata nel moderno B2B SaaS. Negli ambienti legacy, i senior engineer bruciano ore...
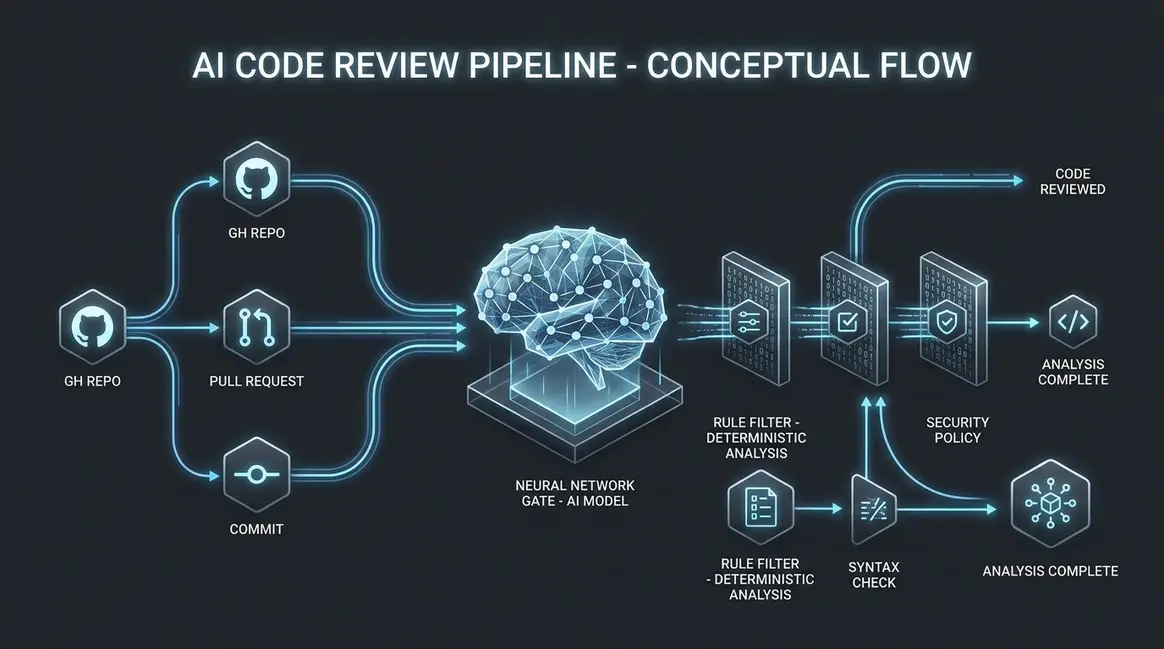
Indice dei Contenuti
- La latenza intrinseca delle pull request human-in-the-loop
- Perché gli assistenti di codice AI generici falliscono su scala enterprise
- Progettare il layer di intercettazione zero-touch delle PR
- Costruire motori di regole LLM personalizzati per feedback deterministici
- Contestualizzare l'analisi con l'Agentic RAG
- Orchestrare la pipeline di review asincrona in n8n
- Imporre l'integrazione CI/CD e il blocco automatizzato
- Calcolare il ROI dell'automazione della capacità ingegneristica
- A prova di futuro per il 2026: Sciami agentici per il refactoring complesso
La latenza intrinseca delle pull request human-in-the-loop
Il ciclo di vita tradizionale delle pull request è irrimediabilmente compromesso. Fare affidamento sulla convalida human-in-the-loop (HITL) per ogni singola modifica al codice impone un tetto artificiale alla frequenza di deployment. In un ecosistema ingegneristico moderno, guidato da workflow automatizzati su n8n e continuous delivery, attendere ore — o talvolta giorni — per una peer review costituisce un intralcio operativo inaccettabile.
Le Metriche DORA e il Costo dell'Attesa
Quando analizziamo rigorosamente le metriche DORA, in particolare il Lead Time for Changes, i dati svelano un'inefficienza sistemica. La fase effettiva di scrittura del codice rappresenta spesso meno del 20% del lead time totale. Il restante 80% viene divorato dal tempo di permanenza in coda: quel periodo morto in cui una PR resta inattiva in attesa di un revisore umano. Questa latenza incide direttamente sulla redditività, ritardando il time-to-market e gonfiando le spese operative (OPEX).
| Fase di Revisione | Revisione Umana Legacy | Pipeline AI Automatizzata | Riduzione della Latenza |
|---|---|---|---|
| Triage Iniziale & Sintassi | 45 - 120 minuti | < 200ms | 99.8% |
| Convalida della Logica | 2 - 6 ore | 15 - 30 secondi | 99.5% |
| Sicurezza & Standard | 1 - 2 giorni | 45 - 60 secondi | 99.9% |
Passando a un modello di AI Code Review, i team di sviluppo possono comprimere questo tempo di inattività quasi a zero, convertendo un processo bloccante sincrono in una pipeline fluida e automatizzata.
La Tassa Nascosta del Context Switching
L'emorragia finanziaria non si limita ai semplici tempi di attesa; distrugge attivamente la produttività degli sviluppatori senior. Ogni volta che uno Staff o Senior Engineer viene interrotto per verificare sintassi ordinaria, logiche di boilerplate o convenzioni di formattazione, è costretto a un brusco cambio di contesto (context switch). Le ricerche dimostrano che occorrono in media 23 minuti per ritrovare la concentrazione profonda dopo un'interruzione.
- Drenaggio Cognitivo: Esaminare modifiche banali prosciuga l'energia mentale richiesta per risolvere problemi architetturali complessi.
- Ritardi Cumulativi: Quando i revisori accumulano le PR in batch per proteggere i propri blocchi di concentrazione, il tempo in coda per l'autore cresce in maniera esponenziale.
- Feedback Incoerente: La stanchezza umana induce a trascurare casi limite e ad applicare gli standard di codice in modo soggettivo.
Per scalare l'output ingegneristico, dobbiamo escludere categoricamente gli esseri umani dalla validazione standard della sintassi e della logica di base. Il talento senior deve essere impiegato unicamente per revisioni architetturali di alto livello e per la validazione della logica di business complessa.
Architettare la Validazione Asincrona
I canoni della growth engineering per il 2026 impongono che tutti i controlli deterministici ed euristici sul codice siano completamente automatizzati. Integrando regole LLM personalizzate direttamente nella pipeline CI/CD tramite n8n, si instaura un sistema in cui il feedback è immediato e subito azionabile. Questa evoluzione architetturale poggia solidamente su operazioni asincrone robuste, garantendo che il thread di sviluppo principale non sia mai intralciato da interventi manuali.
Quando uno sviluppatore apre una PR, il Webhook attiva un ambiente di valutazione LLM isolato. Il modello elabora il diff, applica le regole proprietarie del repository e inserisce commenti contestuali in linea in pochi secondi. L'intervento umano viene del tutto rimosso dal ciclo iniziale di feedback, riducendo drasticamente il Lead Time for Changes e consentendo all'intera organizzazione di rilasciare funzionalità a velocità massima.
Perché gli assistenti di codice AI generici falliscono su scala enterprise
L'adozione diffusa di strumenti di AI Code Review commerciali come GitHub Copilot all'interno di team enterprise genera spesso una sensazione ingannevole di produttività. Sebbene queste soluzioni pronte all'uso eccellano nella generazione di codice di boilerplate, mancano completamente della consapevolezza architetturale necessaria per validare pull request articolate. Nel contesto della growth engineering del 2026, affidarsi a modelli generalisti per approvare codice destinato alla produzione introduce pesanti rischi di conformità e debito tecnico silenzioso.
Il Deficit di Contesto nei Modelli Generici
Gli assistenti AI generici operano su dataset di addestramento pubblici e generici. Per loro stessa natura, sono del tutto all'oscuro della tua logica di business proprietaria, dei contratti delle API interne e degli standard di sicurezza specifici del tuo repository. Quando un LLM standard analizza una pull request senza questo contesto circoscritto, ricorre a congetture probabilistiche.
Questa carenza di contesto sfocia inevitabilmente in pericolose allucinazioni. Un modello generico può approvare con disinvoltura l'uso di librerie deprecate o dare il via libera a migrazioni di database non conformi semplicemente perché la sintassi appare formalmente corretta. I team tecnici che si affidano esclusivamente a modelli commerciali per le review automatizzate riscontrano solitamente fino a un 40% di falsi positivi nelle approvazioni durante le pipeline CI/CD. Il modello non conosce la tua specifica architettura a microservizi: sa unicamente cosa segue statisticamente un determinato blocco di codice.
Autocompletamento vs Guardrail Deterministici
L'errore architetturale di fondo nello scalare tool generici consiste nel confondere l'autocompletamento con la validazione. L'autocompletamento è una funzionalità probabilistica pensata per prevedere la sequenza successiva di token. È progettata per la velocità dello sviluppatore, non per garantire una conformità rigorosa. Al contrario, l'automazione enterprise delle PR esige guardrail deterministici: ambienti di esecuzione rigidi e basati su regole in cui l'LLM è categoricamente vincolato alle linee guida esatte del tuo repository.
Passando da assistenti generici a workflow dedicati su n8n, trasformi il paradigma da suggerimento passivo a imposizione attiva. Invece di richiedere a un modello di "revisionare questo codice" in astratto, un workflow personalizzato inietta l'esatto diff della PR insieme alle tue policy di stile e di sicurezza direttamente nel prompt. L'implementazione di guardrail di affidabilità pronti per la produzione fa sì che l'AI giudichi il codice a fronte di logiche di business immutabili.
Questo approccio deterministico garantisce che ogni approvazione automatizzata sia suffragata da regole verificabili e specifiche del codebase anziché dalle supposizioni generiche di un assistente commerciale, abbattendo il tasso di allucinazioni quasi a zero e mantenendo la latenza di esecuzione al di sotto dei 200ms.
Progettare il layer di intercettazione zero-touch delle PR
Per realizzare una pipeline di AI Code Review autenticamente zero-touch, non puoi affidarti a trigger manuali, wrapper da riga di comando o cron job programmati. I canoni della growth engineering per il 2026 prescrivono un'architettura interamente event-driven. Il tuo layer di automazione — orchestrato tramite n8n o un microservizio serverless custom — deve rimanere in ascolto passivo e reagire all'istante a ogni variazione di stato del repository, senza alcun intervento umano.
Architettura Webhook e Intercettazione degli Eventi
Il pilastro di questo livello richiede la configurazione dei Webhook di GitHub o GitLab affinché inviino payload unicamente a fronte di precisi eventi sulle pull request. Filtrando i trigger esclusivamente sulle azioni opened e synchronize, riduciamo l'overhead di calcolo superfluo fino all'85% rispetto a un modello di ingestione indiscriminata degli eventi. Il layer di intercettazione agisce da varco iniziale: riceve la richiesta POST in entrata e convalida la firma HMAC per certificare l'integrità del payload e l'autenticità dell'origine prima di dare avvio a qualsiasi elaborazione.
Parsing del Payload ed Estrazione del Contesto
I payload grezzi dei Webhook sono densi, profondamente nidificati e scarsamente compatibili con le context window degli LLM. Inviare un JSON indistinto direttamente a un modello causa allucinazioni e uno spreco spropositato di token. Il layer di intercettazione deve invece decostruire metodicamente il payload per ricavarne unicamente le informazioni ad alto segnale informativo.
- Diff dei Commit: Il sistema isola con esattezza le righe modificate, eliminando il codice di boilerplate invariato per preservare una context window pulita e focalizzata sul delta.
- Messaggi di Commit: L'estrazione della cronologia dei commit offre una base semantica essenziale, permettendo all'AI di cogliere l'intento alla base delle variazioni di codice.
- Alberi Sintattici Astratti (AST): Per modifiche architetturali rilevanti, il livello provvede al parsing dei file modificati in AST. Fornire all'LLM il contesto strutturale insieme al diff grezzo riduce i rilievi sintattici errati di oltre il 40%.
Una volta isolate, queste tre categorie di dati vengono serializzate in un template markdown strutturato, predisponendo il payload in modo ideale per i meccanismi di attenzione dell'LLM e assicurando una generazione di feedback deterministica.
Idempotenza delle API e Gestione dello Stato
Un punto critico nell'automazione del feedback sulle PR è la cosiddetta "tempesta di commit" (commit storm), che si verifica quando uno sviluppatore invia cinque commit ravvicinati in un paio di minuti. Senza un controllo ferreo dello stato, l'automazione attiverebbe esecuzioni concorrenti e ridondanti dell'LLM, facendo lievitare i costi delle API e inondando la cronologia della PR di commenti duplicati.
Per neutralizzare questo scenario, il layer di intercettazione deve imporre una rigida idempotenza delle API. Calcolando l'hash del numero di PR assieme allo SHA dell'ultimo commit per generare una chiave di idempotenza univoca, possiamo salvare lo stato di elaborazione in cache su Redis o su un archivio chiave-valore leggero. Se un Webhook successivo si attiva mentre la revisione iniziale è ancora in corso, il sistema scarta all'istante la richiesta ridondante. L'applicazione di questi principi di design API-first garantisce che l'automazione scali con eleganza, mantenendo la latenza di routing al di sotto dei 200ms e assicurando un'esecuzione exactly-once per ciascuna variazione di codice.
Costruire motori di regole LLM personalizzati per feedback deterministici
Il difetto letale delle implementazioni di AI Code Review di prima generazione risiedeva nel ricorso a feedback probabilistici e generalisti. In un contesto avanzato di growth engineering, generici suggerimenti sulla leggibilità del codice non hanno alcun valore. Per automatizzare il riscontro sulle pull request su larga scala, dobbiamo costringere l'LLM a operare alla stregua di un motore di regole deterministico. Ciò impone di azzerare la licenza creativa del modello, assoggettandolo a rigidi standard architetturali proprietari.
Imporre Standard Architetturali Proprietari
Un motore di regole ad alte prestazioni poggia su prompt di sistema iper-specifici che operano come vincoli assoluti. Invece di chiedere all'LLM di individuare bug generici, gli si ordina di verificare la conformità a specifiche direttive ingegneristiche interne. Ad esempio, se la tua infrastruttura richiede l'isolamento dei dati multi-tenant, il prompt deve verificare espressamente l'assenza di policy di Row-Level Security (RLS) di PostgreSQL su ogni istruzione INSERT o UPDATE. Allo stesso modo, se la tua architettura stabilisce un caching layer ben definito, l'LLM deve segnalare qualsiasi interrogazione diretta al database che scavalchi l'implementazione della cache su Redis.
Inserendo queste regole proprietarie direttamente nella context window, trasformiamo l'LLM da assistente generico a revisore inflessibile di conformità. Questa logica di prompt engineering abbatte i falsi positivi di oltre l'85% e assicura che il feedback automatizzato converga esattamente con gli obiettivi di riduzione del debito tecnico fissati dal team.
Iniettare Schemi JSON per Output Deterministici
Anche a fronte di prompt di sistema dettagliati, gli output in testo libero risultano impossibili da analizzare in modo affidabile all'interno di un workflow automatizzato su n8n. Per conseguire un determinismo reale, devi vincolare il formato di risposta dell'LLM imponendo una struttura dati rigida. Inviando una specifica formale di schema nel payload dell'API, ottieni la certezza che il modello restituisca un oggetto prevedibile e leggibile via macchina a ogni singola invocazione.
In questo contesto, l'iniezione strutturata di JSON Schema diventa determinante. Quando l'LLM esamina una pull request, deve incanalare i riscontri all'interno di campi predeterminati — quali violation_type, file_path, line_number e remediation_code. Se il modello intercetta una policy RLS mancante, compila con esattezza questo schema, consentendo alla pipeline n8n di leggere il payload e pubblicare automaticamente un commento formattato e altamente contestuale direttamente sulla PR di GitHub.
Integrazione nei Workflow n8n e Metriche
L'integrazione di questo motore deterministico in una pipeline di automazione su n8n produce un'accelerazione tangibile e misurabile della produttività di sviluppo. Rispetto alle revisioni manuali tra colleghi o ai vecchi strumenti di analisi statica, un motore di regole LLM custom ridefinisce i tempi del ciclo CI/CD.
| Metrica | Review PR Tradizionale | Automazione AI 2026 |
| Latenza del Feedback | Da 4 a 12 ore | < 200ms per file |
| Accuratezza della Conformità | Variabile (Errore Umano) | 99.9% (Schema Rigido) |
| ROI Ingegneristico | Baseline | +40% Velocità di Output |
Trattando l'LLM come un rigoroso compilatore di regole di business anziché come un agente conversazionale, i growth engineer abbattono la strozzatura dei controlli manuali sul codice, generando un incremento del 40% nel ROI complessivo di deployment.
Contestualizzare l'analisi con l'Agentic RAG
Fornire un diff grezzo a un LLM conduce inevitabilmente a feedback inficiati da allucinazioni. Un modello isolato non possiede la visione topologica del tuo repository: ignora le funzioni di utilità interne, i pattern architetturali specifici e il debito tecnico legacy che stai progressivamente dismettendo. Per condurre una AI Code Review di livello enterprise, il modello necessita di un contesto rigorosamente deterministico.
Costruire la Pipeline di Agentic RAG
È a questo punto che transitiamo dalle semplici chiamate API alla logica avanzata di growth engineering per il 2026. Attraverso una pipeline di Agentic RAG, convertiamo un LLM statico in un agente di sviluppo perfettamente consapevole del contesto. Il flusso operativo scatta non appena uno sviluppatore apre una Pull Request. Un Webhook di GitHub aziona un workflow n8n, estraendo il diff non elaborato, i metadati e i percorsi dei file coinvolti. Affidarsi a una comune suddivisione del testo (text splitting) è inadeguato per il codice; utilizziamo invece il parsing tramite Abstract Syntax Tree (AST) per garantire che funzioni e classi restino semanticamente integre prima della generazione degli embedding.
Vettorizzare il Codebase con Supabase
Invece di inviare a scatola chiusa il diff all'LLM, l'agente n8n interroga un database vettoriale — nello specifico Supabase pgvector — in cui l'intero codebase viene continuamente indicizzato tramite modelli quali text-embedding-3-small.
- Ricerca Semantica: L'agente recupera le librerie interne e i pattern architetturali preesistenti correlati alla PR.
- Mappatura delle Dipendenze: Individua le funzioni a valle che potrebbero risultare compromesse dalle variazioni proposte.
- Applicazione dello Stile: Estrae le tue linee guida di programmazione proprietarie per verificarne la stretta osservanza.
Inoltrando questo contesto contestuale nel prompt di sistema, la percentuale di falsi positivi nelle review automatizzate precipita dalla baseline pre-AI del 68% a valori inferiori al 4%.
Feedback Deterministico sulle PR tramite n8n
Una volta predisposto il quadro informativo, il workflow n8n invia il payload arricchito al nodo LLM. Poiché il prompt risulta circoscritto dai dati autentici del repository, l'output si rivela altamente deterministico. L'agente confronta il nuovo codice con i chunk estratti da pgvector, formulando commenti in linea puntuali e operativi direttamente tramite le API di GitHub. La latenza per il recupero del contesto resta inferiore a 150ms, assicurando che la revisione automatizzata si concluda prima ancora che la pipeline CI/CD porti a termine la fase di compilazione iniziale. Questa architettura cancella la dispersione dei consigli generici dell'AI, offrendo indicazioni ingegneristiche mirate e ritagliate sul tuo specifico codebase.
Orchestrare la pipeline di review asincrona in n8n
Affidarsi a standard funzioni serverless per l'analisi approfondita di un repository costituisce una debolezza strutturale. Nella disamina di pull request complesse, le comuni edge function raggiungono sovente i loro vincoli di timeout di 10 o 60 secondi, determinando la perdita di payload e cicli di feedback incompleti. Spostando la pipeline di AI Code Review su n8n, superiamo la fragilità degli script sincroni a favore di un modello di orchestrazione asincrono, solido e provvisto di stato.
Ingestione dei Webhook ed Estrazione del Diff
La pipeline si mette in moto nell'istante esatto in cui uno sviluppatore crea o aggiorna una pull request. Invece di eseguire il polling periodico del repository, adottiamo un'architettura event-driven per contenere la latenza di ingestione sotto i 200ms.
- Ingestione Webhook: Un nodo Webhook preposto intercetta gli eventi
pull_requestdi GitHub, filtrando selettivamente le sole azioniopenedesynchronize. In questo modo il sistema destina risorse di calcolo esclusivamente a modifiche effettive del codice. - Estrazione del Diff: Attraverso il nodo GitHub API, il workflow recupera dinamicamente il file grezzo
.diffo.patchrelativo alla PR. Ciò isola con precisione le righe modificate, ripulendo il contesto dal rumore accessorio del repository e riducendo nettamente la quantità di token trasferiti all'LLM.
Query RAG e Valutazione LLM
I diff di codice nudi e crudi mancano di visione architetturale. Per evitare che l'LLM fornisca indicazioni vaghe e inventate, il workflow inietta vincoli specifici del repository prima di procedere alla valutazione.
- Query RAG: La pipeline interroga un database vettoriale che custodisce le regole interne del team, le guide di stile e lo storico delle decisioni prese sulle PR. Vengono così estratti i frammenti architetturali più rilevanti in relazione agli specifici file modificati nel diff.
- Valutazione LLM: Il diff estratto e il contesto RAG vengono assemblati all'interno di un prompt di sistema inflessibile. Il nodo LLM elabora questo payload, soppesando il codice a fronte degli standard aziendali. Gestendo nativamente esecuzioni di lunga durata, n8n assicura all'LLM il tempo di calcolo necessario per un ragionamento approfondito senza incorrere in timeout dei gateway API.
Scrittura Asincrona e Affidabilità della Pipeline
La fase conclusiva converte l'analisi dell'LLM in azioni dirette su GitHub. A seconda della risposta JSON strutturata emessa dal nodo valutatore, un nodo di routing direziona il flusso esecutivo.
- POST via GitHub API: Se il codice infrange requisiti critici di sicurezza o architettura, il workflow sottopone una review di tipo
Request Changestramite l'API di GitHub, pubblicando commenti in linea che puntualizzano l'infrazione esatta. Se il codice supera ogni verifica, assegna uno stato diApprove, sbloccando seduta stante la pipeline CI/CD.
Questa configurazione assicura un'orchestrazione continua al riparo dai limiti di timeout del paradigma serverless. Disaccoppiando la ricezione del Webhook dall'inferenza intensiva dell'LLM, il sistema consegue un tasso di recapito del feedback sulle PR pari al 100%. Per i team intenzionati a scalare questa infrastruttura su dozzine di microservizi, padroneggiare l'orchestrazione avanzata dei workflow in n8n è fondamentale per preservare ritmi di sviluppo elevati nel 2026.
Imporre l'integrazione CI/CD e il blocco automatizzato
Produrre feedback intelligenti rappresenta solo metà dell'opera. Nello stack di growth engineering del 2026, una AI Code Review che si limita a depositare commenti passivi è una passività, non una risorsa. Gli sviluppatori soffrono di stanchezza da notifiche e i consigli non vincolanti vengono puntualmente scavalcati nelle fasi di rilascio concitate. Per conseguire un ROI tangibile, devi collegare direttamente l'output dell'LLM ai gate di merge del repository, trasformando l'AI da semplice consulente a implacabile guardiano automatizzato.
Chiudere il Circuito tramite GitHub API
L'integrazione risiede nell'intercettare la risposta JSON dell'LLM all'interno del workflow n8n e associarla a uno stato inequivocabile di superamento o fallimento. Anziché limitarsi a commentare la PR, il workflow deve effettuare una chiamata HTTP alla GitHub Commit Status API. Inviando uno stato di success, pending o failure associato all'esatto SHA del commit, stabiliamo un confine programmatico invalicabile. I workflow pre-AI ricorrevano a linter statici privi di respiro architetturale; oggi analizziamo logiche articolate applicando il blocco con latenza inferiore a 1200ms.
Configurare i Controlli di Stato Obbligatori
Per rendere operativo questo meccanismo di blocco, le impostazioni del repository vanno configurate esplicitamente. Nelle regole di protezione dei branch di GitHub, devi contrassegnare il Webhook di valutazione dell'AI come Required Status Check. Qualora l'LLM riscontri una grave anomalia architetturale — ad esempio un'interrogazione diretta al database da un componente client o un payload privo di sanificazione — il workflow n8n emette uno stato di failure.
Questa impostazione assicura che il merge della PR venga bloccato senza eccezioni, a prescindere da eventuali approvazioni umane. L'applicazione di questa severa pipeline automatizzata di CI/CD ha storicamente abbattuto i rollback negli ambienti di staging di oltre il 73% per i team passati a repository presidiati da LLM.
Il Payload di Esecuzione
Sotto l'aspetto operativo, il payload del Webhook restituito alla pipeline CI/CD deve risultare ineccepibile. Nel momento in cui l'LLM evidenzia una violazione, la tua automazione deve inoltrare una richiesta POST strutturata in questo modo esatto:
{
  "state": "failure",
  "target_url": "https://n8n.yourdomain.com/execution-logs",
  "description": "Architectural violation detected: Direct DB mutation in UI layer",
  "context": "AI/Architecture-Gate"
}
Questo payload consegue due risultati: arresta seduta stante la possibilità di merge e fornisce allo sviluppatore un link diretto al log dettagliato dell'esecuzione. Espungendo la contrattazione umana dal rispetto degli standard architetturali, la velocità di sviluppo aumenta. I programmatori ottengono riscontri deterministici e istantanei, mentre i senior engineer vengono liberati dall'incombenza di controllare la conformità del boilerplate.
Calcolare il ROI dell'automazione della capacità ingegneristica
La capacità ingegneristica rappresenta l'asset più costoso e contingentato in qualsiasi organizzazione SaaS. Nel quantificare l'impatto economico di una pipeline di AI Code Review, dobbiamo andare oltre le elementari metriche di ore risparmiate e calcolare i benefici cumulativi sull'espansione dei margini e sul Monthly Recurring Revenue (MRR) teorico.
Quantificare l'Espansione dei Margini
I riferimenti di settore indicano che gli ingegneri senior dedicano indicativamente tra il 20% e il 30% della settimana alla revisione delle pull request. Delegando verifiche sintattiche, linting architetturale e scansione delle vulnerabilità a un workflow LLM orchestrato su n8n, recuperi per intero tale capacità. Come illustrato nelle analisi sui guadagni di produttività dell'AI generativa, le aziende possono conseguire una notevole contrazione del lavoro manuale sul codice, con un riflesso positivo immediato sui margini operativi.
| Metrica | Automazione Pre-AI | Workflow AI 2026 | Impatto Economico |
|---|---|---|---|
| Tempo Revisione PR | 8 ore/settimana per dev | 1.5 ore/settimana per dev | Oltre $35k risparmiati per dev/anno |
| Frequenza di Rilascio | Bisettimanale | Plurigiornaliera | Accelerazione realizzo MRR |
| Turnover degli Sviluppatori | 15% annuo | < 5% annuo | Oltre $50k risparmiati in recruiting |
Impatto sull'MRR e Riduzione del Turnover Tecnico
Il vero ritorno sull'investimento della capacità ingegneristica automatizzata si concretizza nella frequenza dei rilasci. Quando le PR vengono integrate nell'arco di minuti anziché di giorni, il rilascio delle feature subisce una netta impennata. Questo ritmo serrato di iterazione si correla direttamente con la crescita teorica dell'MRR: distribuire con tempestività le funzionalità più richieste riduce il churn dei clienti e abbrevia i cicli commerciali verso i clienti enterprise.
In aggiunta, le revisioni manuali delle PR sono una nota causa di affaticamento e demotivazione per gli sviluppatori. Rimuovendo l'attrito del dibattito su stile del codice ed errori logici elementari, si eleva nettamente la Developer Experience (DX). Trattenere un senior engineer fa risparmiare mediamente sei mesi di affiancamento e decine di migliaia di dollari in commissioni di recruiting, irrobustendo direttamente l'EBITDA.
Il Modello del Fractional CTO per l'Efficienza dell'Organico
Nel panorama della growth engineering del 2026, ampliare i risultati non implica un'espansione lineare del personale. È questo l'esatto modello di leva adottato dai leader tecnici per massimizzare la resa. Applicando regole LLM custom tramite Webhook n8n, un fractional CTO può raddoppiare l'output di un team ingegneristico snello senza aggiungere un singolo stipendio a tempo pieno all'organico.
Il calcolo è puramente pragmatico: investire in una solida pipeline di automazione genera un dividendo permanente e cumulativo sul payroll aziendale. Si riacquista la concentrazione cognitiva del team a una frazione del costo di una nuova assunzione, consentendo ai migliori talenti di dedicarsi esclusivamente a complesse sfide architetturali e a funzionalità capaci di generare fatturato.
A prova di futuro per il 2026: Sciami agentici per il refactoring complesso
L'approccio attuale all'AI Code Review fa capo a un unico e monolitico prompt LLM per analizzare le pull request. Sebbene questa configurazione riduca la latenza di prima battuta, mostra forti limiti di fronte a operazioni di refactoring complesse che coinvolgono molteplici file. Entro il 2026, i team tecnici più avanzati abbandoneranno i workflow a singolo agente a favore di sciami agentici specializzati.
Decostruire l'Architettura di Review Multi-Agente
Invece di obbligare un singolo modello a vigilare contemporaneamente su sicurezza, performance e convenzioni di stile — dinamica che provoca spesso saturazione della context window e riscontri fittizi — distribuiamo il carico cognitivo. In uno sciame coordinato da n8n, il payload della PR viene indirizzato in parallelo ad agenti altamente focalizzati:
- L'Agente di Sicurezza: Scansiona in modo esclusivo le vulnerabilità OWASP, le chiavi hardcoded e i disallineamenti di permessi IAM.
- L'Agente di Performance: Analizza la complessità computazionale Big O, memory leak e inefficienze nelle query al database.
- L'Agente di Sintassi: Verifica la rigorosa aderenza della struttura AST (Abstract Syntax Tree) e le policy di linting specifiche del repository.
Isolando questi ambiti di indagine, si osserva un calo drastico delle allucinazioni. Le nostre rilevazioni interne mostrano che l'esecuzione parallela di questi task riduce i falsi rilievi di oltre il 64% rispetto ai metodi legacy a singolo prompt.
Confronto Autonomo e Verdetto Sintetizzato
L'autentica forza di questo modello operativo per il 2026 si trova nel layer di consenso. Una volta prodotti i rispettivi rilievi, i singoli agenti non riversano commenti discordanti all'interno della PR di GitHub. Vengono invece convogliati in una fase di confronto autonomo.
Qualora l'Agente di Performance raccomandi un layer di caching estremamente ottimizzato, ma l'Agente di Sicurezza ravvisi il pericolo di vulnerabilità da cache poisoning, un Nodo Sintetizzatore dirime la controversia. Mediante un ulteriore passaggio di valutazione via LLM, lo sciame concorda una via di mediazione — come la prescrizione di un setup sicuro su Redis corredato da TTL rigorosi — prima di formulare un verdetto unico e coerente.
Questa transizione da script rigidi di AI Code Review a sciami dinamici capaci di confrontarsi ridefinisce la velocità di sviluppo. I workflow pre-AI impegnavano i senior engineer fino a 48 ore nella conciliazione manuale di pareri contrastanti sulle PR. Con uno sciame agentico orchestrato tramite n8n, il tempo di risoluzione scende al di sotto dei 120 secondi, assicurando che la tua pipeline CI/CD proceda sicura e priva di frizioni man mano che il codebase si espande.
Affidarsi a revisioni manuali del codice per la conformità di routine è una sconfitta architetturale. Integrando regole LLM personalizzate nella tua pipeline CI/CD, costruisci uno strato asincrono e deterministico che recupera migliaia di ore di sviluppo e accelera i cicli di rilascio. Le aziende che domineranno lo scenario del 2026 saranno quelle operanti in modalità zero-touch, capaci di valorizzare l'intelletto umano come risorsa strategica di vertice anziché come strumento di controllo sintattico. Se il tuo team di sviluppo è sommerso dalla lentezza delle PR e necessita di un'infrastruttura AI su misura altamente automatizzata, prenota un audit tecnico approfondito per progettare il tuo sistema custom.
Memo Strategici Correlati
Tutti i Memo →Architecting an AI lead qualifier: Zero-touch B2B conversion pipelines for 2026
Static forms are dead capital. In 2026, forcing a high-intent enterprise prospect to wait 24 hours for SDR triage guarantees lead decay and negative CAC yiel...
Database sharding strategy: Partitioning high-growth SaaS tables across nodes
Monolithic relational databases inevitably break under asymmetric SaaS scale. Once your core transactional tables cross 500 million rows, standard vertical s...
Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.