Architettura dei growth team: strutturare engineering e marketing in pod autonomi
Il design organizzativo tradizionale del B2B SaaS è profondamente inefficiente. Quando l'engineering opera all'interno di rituali di sprint isolati di due settimane e il marketing esegue campagne slegate, la velocità dei ricavi ne risente. Questo memo illustra l'architettura dei growth pod autonomi per eliminare l'attrito dei ticket e scalare la pipeline.
Indice dei contenuti
- Il fallimento strutturale dei silos funzionali nel B2B SaaS moderno
- Decostruire il growth pod: topologie matematiche per il throughput cross-funzionale
- Il contratto API-first: disaccoppiare la velocità di marketing dalle codebase di prodotto core
- Frontend componibili: implementare microfrontend per superfici di acquisizione autonome
- Architettura di telemetria unificata: eliminare l'attribution drift tra prodotto e acquisizione
- Pipeline di automazione agentica: integrare n8n e server MCP per l'esecuzione zero-touch della crescita
- Governance, guardrail e allocazione algoritmica delle risorse
- Il blueprint di migrazione a 90 giorni: transizione da dipartimenti monolitici a unità pod
Il fallimento strutturale dei silos funzionali nel B2B SaaS moderno
Nelle organizzazioni enterprise B2B SaaS tradizionali, segregare engineering e marketing in dipartimenti orizzontali isolati rappresenta la via più rapida per soffocare la velocità del fatturato. Questa struttura legacy crea un collo di bottiglia operativo: ogni iniziativa cross-funzionale deve superare code di ticket interdipartimentali, raccolta asincrona dei requisiti e frizioni di prioritizzazione. Allontanarsi da questi silos dipartimentali non è una mera preferenza manageriale; come evidenziato dalla ricerca sui modelli operativi di nuova generazione, rimuovere gli handoff strutturali è indispensabile per eliminare la latenza e comprimere i tempi del ciclo di deployment su tutti i touchpoint digitali.
L'asimmetria degli incentivi e il ritardo dello sprint di 21 giorni
Il problema alla radice dell'allineamento funzionale orizzontale risiede in una divergenza insanabile nei Key Performance Indicator (KPI):
-
I team di engineering sono incentivati a ottimizzare manutenibilità del codice, release a zero difetti, uptime di sistema e riduzione del debito tecnico.
- I team di growth e marketing sono incentivati a ottimizzare la velocità della pipeline, il volume di sperimentazione, l'incremento del tasso di conversione e l'acquisizione immediata di clienti.
Quando questi gruppi operano in silos, una semplice iniziativa di crescita — come la modifica di uno step nel form di onboarding, la creazione di un calcolatore ROI interattivo o l'emissione di telemetria granulare verso il moderno data stack — si trasforma in una richiesta esterna. I marketer aprono un ticket nel backlog dell'engineering del prodotto core, dove finisce relegato dietro alle roadmap delle feature rivolte agli utenti e agli sprint di refactoring. Nel B2B SaaS enterprise, questo tempo morto dello sprint dura mediamente tra 14 e 21 giorni. Nel momento in cui un engineer esamina la PR, la finestra di mercato o l'ipotesi di test ha perso contesto, e lo spreco finanziario di budget marketing inutilizzato si accumula giornalmente.
Una Growth Team Architecture resiliente risolve questa impasse strutturale integrando software engineer full-stack direttamente nei cicli di acquisizione e attivazione, eliminando completamente la latenza di coda.
Shadow IT, DOM Bloat e il collasso dei Core Web Vitals
Quando i backlog di engineering respingono i ticket del marketing, gli operatori di growth non smettono di sperimentare: aggirano il controllo tecnico. Questo attrito operativo genera inevitabilmente lo "Shadow IT".
Privi di accesso diretto alla codebase, i team di demand generation iniettano tag manager client-side di terze parti non verificati, script di split test, librerie di Customer Data Platform (CDP) e SDK di session recording comportamentale direttamente nei container di produzione. Poiché questi script vengono caricati al di fuori della pipeline di Continuous Integration e Continuous Deployment (CI/CD), introducono gravi effetti collaterali architetturali:
-
Blocco del Main Thread: bundle JavaScript non ottimizzati monopolizzano il thread di esecuzione del browser, gonfiando il Total Blocking Time (TBT) e innescando punteggi degradati di Interaction to Next Paint (INP).
-
Instabilità asincrona del layout: elementi visivi iniettati dopo la costruzione del DOM causano reflow imprevedibili e un severo Cumulative Layout Shift (CLS).
-
Contesa di rete: molteplici SDK esterni inviano chiamate HTTP concorrenti, saturando la larghezza di banda e ritardando la consegna degli asset critici della pagina.
-
L'effetto a valle è paradossale: i growth team implementano strumenti di tracciamento e sperimentazione per aumentare il fatturato, ma le conseguenti dinamiche di caricamento pagina e tassi di conversione subiscono una marcata degradazione. I ranking di ricerca organica crollano a causa del mancato superamento delle soglie dei Core Web Vitals, mentre i tassi di rimbalzo aumentano esponenzialmente sulle landing page ad alto intento prima ancora che il prospect interagisca con la CTA.
Decostruire il growth pod: topologie matematiche per il throughput cross-funzionale
Le squad di engineering tradizionali sono strutturalmente ottimizzate per la delivery di feature, l'integrità architetturale e l'esecuzione lineare della roadmap. Tuttavia, trattare i funnel di conversione e i loop di espansione come ticket software all'interno di una cadenza standard di sprint introduce attriti insormontabili. Per scalare la sperimentazione enterprise, la moderna Growth Team Architecture abbandona i silos funzionali a favore di topologie di pod autonome e matematicamente ottimizzate, progettate attorno al throughput di sistema anziché al burn-down degli story point.
Topologia strutturale e rapporti di staffing
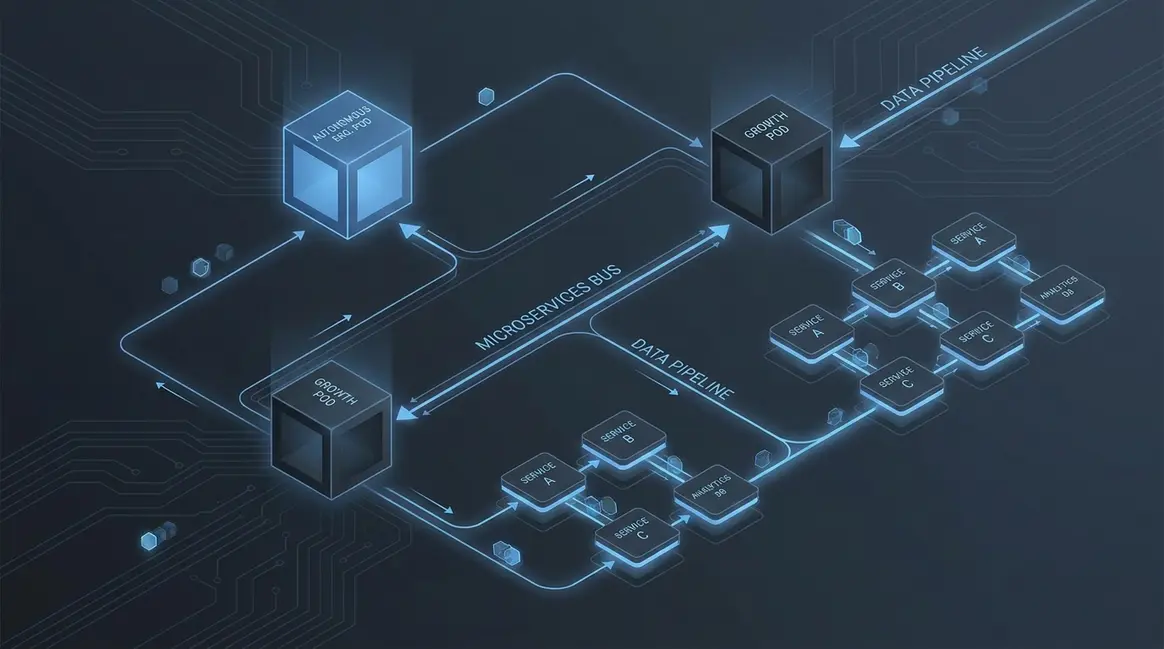
Un Growth Pod resiliente opera come un motore algoritmico integrato. Anziché negoziare favori cross-funzionali o mettere in coda ticket Jira tra dipartimenti scollegati, l'unità racchiude ogni dipendenza fondamentale necessaria per formulare, instrumentare, rilasciare e analizzare un esperimento. La configurazione ottimale del pod scala su una presenza di 4 FTE:
-
1 Lead Growth Engineer: funge da ancora tecnica, gestendo routing edge, SDK di sperimentazione e pipeline di reverse-ETL, garantendo al contempo che la qualità del codice non degeneri in debito tecnico.
-
1 Full-Stack/Automation Engineer: si concentra sulla velocità di esecuzione, scaffolding rapido di varianti front-end, orchestrazione di webhook e automazione event-driven tramite n8n e worker API interni.
-
1 Technical Marketer / Acquisition Specialist: presidia il backlog quantitativo delle ipotesi, i parametri di copy, i trigger dei canali paid/organic e il ciclo di feedback continuo tra dinamiche go-to-market e codice.
-
0.5 Data / Telemetry Engineer: definisce il semantic layer, mantiene gli schemi clickstream in tempo reale e previene il drift di telemetria tra database di produzione e destinazioni warehouse.
-
0.5 Product Designer: progetta componenti modulari del design system, stati di variante e micro-interazioni ottimizzate per ridurre il carico cognitivo e accelerare l'istanziazione della UI.
-
Questa topologia si distacca radicalmente dai setup scrum tradizionali. Nelle squad convenzionali, la responsabilità è incentrata sull'output: rilasciare ticket, completare epic e chiudere pull request. All'interno di un pod autonomo, la responsabilità ingegneristica ruota rigorosamente attorno a metriche di sistema quantificabili, tra cui l'Activation Rate, l'espansione della Net Revenue Retention (NRR) e la velocità della pipeline organica.
La Legge di Little e le dinamiche di accodamento del backlog
La giustificazione matematica del modello a growth pod affonda le radici nella ricerca operativa e nella teoria delle code (Queuing Theory), governata dalla Legge di Little:
L = λ × W
Dove L rappresenta il Work In Progress (il totale degli esperimenti attivi tra ideazione, design e deployment), λ è il throughput del sistema (deployment completati per unità di tempo) e W è il cycle time (la latenza dalla concezione dell'ipotesi alla significatività statistica). Esplicitando per il cycle time si ottiene W = L / λ.
Nei silos enterprise convenzionali, catene di approvazione interdipartimentali, verifiche di conformità e pianificazioni disgiunte degli sprint iper-inflazionano il WIP (L). Un'ipotesi deve attraversare revisioni di marketing, allineamenti di design, raffinamenti del backlog di core engineering e cicli manuali di QA. Poiché il WIP attivo si dilata mentre il throughput (λ) rimane strozzato dall'attrito dei passaggi di consegne, la latenza del ciclo (W) degrada esponenzialmente — estendendo spesso le finestre di iterazione a 28 giorni o più.
Eliminando i gate di approvazione esterni, eseguendo suite di regressione automatizzate e vincolando la concorrenza del pod (impostando limiti rigorosi di WIP in cui L ≤ 3 esperimenti simultanei per engineer), il cycle time crolla a meno di 48 ore. Quando il cycle time si riduce di un ordine di grandezza, la capacità di testing del sistema si espande dinamicamente, capitalizzando i successi statistici su cicli fiscali più brevi.
| Metrica Operativa | Modello a Silos Funzionali | Growth Pod Autonomo |
|---|---|---|
| WIP Medio (L) | 18-25 ticket concorrenti | 3-5 esperimenti attivi |
| Cycle Time (W) | 28 giorni (672 ore) | Meno di 48 ore |
| Throughput Settimanale (λ) | 0.5-1 deployment di produzione | 5-8 iterazioni convalidate |
| Metrica Chiave di Successo | Story Point Completati | Delta di Pipeline e Conversione |
Il contratto API-first: disaccoppiare la velocità di marketing dalle codebase di prodotto core
Scalare la velocità di acquisizione senza introdurre rischi esistenziali nei sistemi di produzione richiede una rigorosa separazione delle responsabilità. Nelle architetture legacy, i growth team inviano costantemente pull request verso i repository monolitici core per distribuire test di conversione, modificare step di onboarding o inserire pixel di tracciamento hardcoded. Questo accoppiamento genera forti attriti ingegneristici: i gate di deployment bloccano la cadenza del marketing, mentre modifiche fragili al front-end rischiano di destabilizzare i flussi di checkout critici per il business. Una Growth Team Architecture matura tratta le codebase di produzione core come piattaforme black-box accessibili unicamente tramite interfacce programmatiche.
Isolamento headless e motori basati su schemi
Per eliminare le dipendenze a livello di codice tra product engineering e growth pod, tutte le superfici di acquisizione rivolte agli utenti devono essere disaccoppiate tramite un paradigma headless. Lo standard operativo si basa su moderni runtime edge (come Next.js su Vercel o Cloudflare Workers) che interrogano microservizi e piattaforme CMS headless esclusivamente attraverso interfacce validate. I growth pod rilasciano e iterano su motori per landing page in cui composizioni di layout, mapping dinamico dei componenti e variant testing vengono determinati all'edge anziché integrati nei deployment dell'applicazione principale.
L'adozione di un rigoroso approccio API-first design stabilisce confini netti tra consumer e provider. Sotto questo framework, gli ingegneri dell'applicazione core gestiscono la logica di dominio — come autenticazione utente, pipeline di fatturazione e persistenza dei dati — ed espongono endpoint immutabili e autenticati. I growth engineer consumano questi servizi per comporre layer di sperimentazione senza mai richiedere permessi di scrittura nel repository dell'applicazione principale.
Governance dei contratti con payload basati su schemi dinamici
Growth pod autonomi, flussi di lavoro n8n automatizzati e agenti di generazione basati su intelligenza artificiale necessitano di guardrail strutturali affidabili per generare pagine ad alta conversione in modo dinamico. L'impiego di rigide definizioni JSON Schema impone un rendering deterministico dei componenti su tutti i touchpoint headless. Ogni componente UI dinamico — come selettori di pricing matrix, caroselli di testimonianze o form di lead capture — aderisce a espliciti modelli di validazione dati prima dell'idratazione.
Si consideri il confine di payload per un funnel di personalizzazione generato dinamicamente:
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "title": "GrowthFunnelPayload",
  "type": "object",
  "properties": {
    "experimentId": { "type": "string", "pattern": "^exp_[a-zA-Z0-9]{8}$" },
    "targetSegment": { "type": "string" },
    "components": {
      "type": "array",
      "items": {
        "type": "object",
        "properties": {
          "type": { "type": "string", "enum": ["HeroBanner", "PricingTable", "LeadForm"] },
          "props": { "type": "object" }
        },
        "required": ["type", "props"]
      }
    }
  },
  "required": ["experimentId", "targetSegment", "components"]
}
Questa governance dei contratti offre vantaggi architetturali misurabili:
-
Immunità alle regressioni: le pipeline CI/CD automatizzate respingono qualsiasi payload che violi i contratti di schema, prevenendo crash del runtime edge causati da input CMS non validi o allucinazioni degli agenti.
-
Latenza edge inferiore a 100ms: la generazione statica delle pagine (SSG) e l'Incremental Static Regeneration (ISR) vengono eseguite all'edge, riducendo i roundtrip verso il server di origine e mantenendo il Time to Interactive (TTI) ampiamente al di sotto delle soglie di performance.
-
Esecuzione autonoma: marketer tecnici e agenti automatizzati possono comporre, personalizzare e pubblicare funnel di acquisizione iper-targettizzati in pochi minuti, senza avviare cicli di release core né richiedere revisioni ingegneristiche.
-
Frontend componibili: implementare microfrontend per superfici di acquisizione autonome
I growth team ad alta velocità non possono permettersi di rimanere bloccati dai cicli di release monolitici. Quando ogni aggiustamento di headline, esperimento di conversione o landing page localizzata richiede test di regressione end-to-end attraverso layer di database multi-tenant e logiche bancarie o dashboard core, la velocità del ciclo si azzera. La moderna Growth Team Architecture risolve questo rallentamento operativo trattando le superfici di acquisizione come microfrontend autonomi disaccoppiati dall'applicazione core all'edge.
Routing edge e riscrittura deterministica dei percorsi
Il disaccoppiamento non richiede setup di domini frammentati (come sottodomini tipo app.domain.com vs. get.domain.com), che diluiscono l'equity SEO del dominio principale e complicano il tracciamento cross-sottodominio. Al contrario, i layer edge — orchestrati tramite Cloudflare Workers o Vercel Edge Middleware — intercettano il traffico in ingresso ed effettuano il proxy deterministico delle richieste in base ai prefissi URI.
-
Matrice di Routing: le pagine ad alto funnel (
/compare/*,/features/*) vengono instradate verso un generatore di siti statici ottimizzato (es. Next.js SSG o Astro) che serve HTML generato staticamente dalle cache edge con un Time to First Byte (TTFB) inferiore a 40ms.-
Workflow di acquisizione: superfici interattive come
/signup-flowvengono instradate verso una micro-app altamente reattiva che gestisce lo stato transitorio, la validazione client-side e l'ingestione della telemetria prima di inoltrare i payload alle API di onboarding. -
Applicazione Core: i percorsi autenticati (
/dashboard/*,/settings/*,/api/*) vengono inoltrati tramite proxy direttamente all'infrastruttura primaria mission-critical, garantendo che gli esperimenti di crescita non interagiscano mai con i cluster protetti di produzione.
-
Eliminare i test di regressione monolitici e il ritardo delle pipeline
La vittoria principale dei microfrontend all'interno di un growth pod guidato dall'engineering risiede nel contenimento del blast radius. Nei setup tradizionali, la modifica di un campo di input dinamico su un calcolatore di prezzi pubblico impone l'esecuzione di suite di test complete che coprono guard di autenticazione, webhook di fatturazione e protocolli core di isolamento tenant.
Imponendo chiari confini di rilascio, il pod di acquisizione mantiene una pipeline CI/CD indipendente. I growth engineer possono distribuire modifiche a /signup-flow più volte al giorno tramite workflow Git autonomi. Per ottenere questo isolamento senza sacrificare le performance, i nostri team implementano dinamiche di deployment disaccoppiate e strategie di ottimizzazione degli asset che preservano tempi di risposta edge sub-millisecondo ed eliminano dipendenze runtime condivise.
Poiché il microfrontend di acquisizione non eredita i bundle pesanti, i polyfill o le complesse librerie di state management della dashboard interna, il peso del bundle client-side si riduce drasticamente (spesso riducendo i payload JavaScript da 850KB a meno di 65KB). Questo delta prestazionale posiziona direttamente i Core Web Vitals nel 99° percentile, concedendo al contempo al pod di acquisizione completa autonomia per testare, rilasciare e iterare.
Architettura di telemetria unificata: eliminare l'attribution drift tra prodotto e acquisizione
Il modello standard di telemetria nelle startup ad alta crescita è fallace. Le piattaforme pubblicitarie riportano abitualmente 1.000 iscrizioni andate a buon fine, mentre il database di produzione registra soltanto 600 account autenticati. Questa varianza di attribuzione del 40% non è rumore statistico; è un fallimento infrastrutturale causato da ad blocker, dall'Intelligent Tracking Prevention (ITP) di Safari che riduce la durata dei cookie client a 24 ore e da tag client-side persi. All'interno di una moderna Growth Team Architecture, engineering e marketing non possono basarsi su fonti di verità separate. Eliminare questa discrepanza richiede di eliminare del tutto gli script di tracciamento client-side e trattare la telemetria come infrastruttura di produzione.
Ingestione instradata all'edge e risoluzione dell'identità First-Party
Affidarsi a Google Tag Manager nel browser genera un'acquisizione dati fragile. Per garantire un allineamento completo tra acquisizione e coinvolgimento di prodotto, il growth pod deve implementare un modello di event streaming instradato all'edge. Le richieste di rete vengono intermediate tramite un edge worker (come Cloudflare Workers o AWS CloudFront) ospitato direttamente sul dominio root dell'applicazione.
Questo proxy funge da layer sicuro di identity resolution prima di inoltrare payload di eventi puliti a valle:
-
Generazione di First-Party Identifier (FPID): l'edge worker emette un cookie sicuro HTTP-only con scadenza ancorata direttamente al dominio root. Ciò aggira completamente i vincoli di archiviazione temporanea del browser e i blocchi del tracciamento cross-site.
-
Deterministic Identity Stitching: quando un visitatore non autenticato interagisce con un asset di acquisizione, il suo identificativo anonimo di dispositivo e l'FPID vengono associati a ogni hit. All'atto della registrazione, un webhook instradato all'edge collega questo identificativo anonimo allo
user_ide alworkspace_idinterni del prodotto. -
Inoltro con stato: il payload pulito e arricchito viene suddiviso e inviato in modo sincrono agli endpoint di acquisizione e allo storage dati primario utilizzando una solida architettura di tracciamento server-side.
-
Responsabilità del Pod: riconciliare spesa pubblicitaria e verità di prodotto
Nei setup tradizionali, la data engineering esiste come un centro di servizi centralizzato basato su ticket che impiega settimane per eseguire il debug delle perdite di attribuzione. Sotto la struttura a pod autonomo, il data engineer dedicato presidia la pipeline di ingestione dalla ricezione all'edge fino alla modellazione dimensionale finale.
I flussi grezzi di eventi vengono instradati simultaneamente in Supabase per il tracciamento operativo in tempo reale e in Google BigQuery per la modellazione dell'attribuzione longitudinale. Per chiudere il loop di conversione, pipeline di orchestrazione automatizzate tramite n8n interrogano BigQuery a cadenza oraria per estrarre gli eventi reali di prodotto — come il completamento dell'onboarding del team o l'acquisto iniziale di crediti API — e inviare eventi Conversion API (CAPI) ad alta fedeltà alle reti pubblicitarie.
Ingegnerizzando flussi di lavoro automatizzati che uniscono i dati di Google Ads e GA4 in BigQuery con tabelle transazionali, il growth pod rimuove i bias di autoreferenzialità delle piattaforme. I target di marketing non vengono più definiti su metriche speculative delle piattaforme, ma collegati direttamente ad analisi deterministiche del funnel, garantendo che ogni euro investito in marketing sia tracciato nei ricavi effettivi di produzione.
Pipeline di automazione agentica: integrare n8n e server MCP per l'esecuzione zero-touch della crescita
La moderna Growth Team Architecture nel 2026 rifiuta il collo di bottiglia operativo della configurazione manuale degli esperimenti di crescita. I growth pod legacy spendono fino al 60% dei loro cicli di sprint di engineering in attività boilerplate: impalcare varianti programmatiche di landing page, sincronizzare payload webhook tra i CRM e sanificare pipeline di arricchimento dati. Disaccoppiando l'esecuzione grezza dal rilascio manuale del codice, i growth pod si trasformano da fabbriche reattive di task in motori agentici autonomi.
Connettere stato e logica: orchestrazione con n8n e MCP
Il fondamento dell'esecuzione autonoma della crescita si basa sull'unione dell'automazione dei workflow headless con strumenti AI contestuali. I webhook tradizionali trasmettono stringhe JSON statiche; le pipeline agentiche, tuttavia, necessitano di una visibilità contestuale profonda nei dataset interni senza rischiare avvelenamento dei dati o prompt bloat. Implementando server Model Context Protocol (MCP) direttamente sopra repliche di produzione Postgres o istanze Supabase, i team di crescita espongono definizioni di schema, interfacce di esecuzione delle query e guardrail operativi ai modelli di reasoning.
In questa architettura, n8n opera come dorsale deterministica. Si attiva su pianificazione temporale, mutazioni di database o webhook in ingresso, instradando task a LLM locali e sciami di agenti dotati di endpoint MCP. Anziché scrivere query SQL hardcoded attraverso dozzine di microservizi, la pipeline di crescita sfrutta l'architettura di orchestrazione LLM con server MCP in n8n per ispezionare dinamicamente gli stati del database, valutare i parametri di coorte ed eseguire flussi di arricchimento a più passaggi. Questo approccio si integra nativamente con un'architettura di database a progressive disclosure, consentendo all'agente di recuperare solo gli schemi di colonna esatti e le metriche storiche degli esperimenti necessarie per la variazione programmatica immediata, mantenendo la latenza al di sotto di 450ms per esecuzione.
Il loop di validazione e Pull Request zero-touch
L'esecuzione zero-touch della crescita elimina il copia-incolla manuale tra Content Management System (CMS) e repository GitHub. Impone invece un ciclo di vita di verifica automatizzato e auto-riparante:
-
Sintesi degli asset: quando scattano segnali di mercato o eventi nelle code interne, agenti autonomi generano metadati semantici di pagina, redigono testi ottimizzati e compongono dati strutturati JSON-LD conformi e nidificati correttamente.
-
Deployment di staging: il motore n8n elabora l'output validato dell'agente, crea un nuovo branch Git tramite le REST API di GitHub, effettua il commit dei template MDX e avvia un deployment di anteprima effimero (es. Vercel o Cloudflare Pages) in pochi secondi.
-
Smoke Testing automatizzato: worker di audit headless eseguono controlli automatici sui Core Web Vitals e validazioni della sintassi dello schema sull'URL di anteprima. Se si verificano layout shift o gli schemi falliscono la validazione, la pipeline restituisce gli errori grezzi del compilatore all'agente LLM per la correzione iterativa.
-
Controllo Human-in-the-Loop: una volta superata la verifica, n8n invia un payload interattivo a un canale Slack dedicato al growth engineering. L'avviso contiene l'URL di anteprima, istantanee delle differenze visive e punteggi prestazionali.
-
Il growth engineer non scrive componenti boilerplate, non adatta testi né costruisce file di metadati. Clicca semplicemente su un pulsante interattivo "Approve & Merge" all'interno di Slack, che attiva un webhook autenticato per avviare il deployment di produzione. Questo loop comprime i tempi di ciclo degli esperimenti da 72 ore a meno di 4 minuti, stabilendo un vantaggio operativo incolmabile nei mercati competitivi.
Governance, guardrail e allocazione algoritmica delle risorse
La principale obiezione della leadership di engineering enterprise contro i pod autonomi è prevedibile: la velocità corrode la qualità. Quando i team di crescita inseguono rapidi incrementi di conversione, i maintainer del core si preparano ad affrontare hack fragili del DOM, dimensioni dei bundle compromesse, script di tracciamento di terze parti non verificati e debito tecnico che finisce per metastatizzare nel repository principale. Risolvere questo problema richiede di disaccoppiare l'autonomia dall'anarchia. Una Growth Team Architecture resiliente sostituisce la supervisione manuale con controlli di deployment programmatici e non negoziabili.
Gate di regressione CI/CD automatizzati e rispetto della compliance
I growth pod operano su infrastruttura di livello enterprise, il che significa che le loro pull request devono superare gli stessi identici controlli a tolleranza zero delle pipeline dei servizi di piattaforma core. Anziché affidarsi alla peer review per individuare regressioni prestazionali, le pipeline impongono blocchi programmatici all'interno dei flussi CI/CD:
-
Test di regressione dei Core Web Vitals: runner Lighthouse CI sintetici confrontano ogni PR rispetto ai benchmark di produzione. I deployment falliscono automaticamente se il Largest Contentful Paint (LCP) degrada di oltre 100ms, il Cumulative Layout Shift (CLS) supera 0.05 o l'Interaction to Next Paint (INP) oltrepassa i 200ms.
-
Integrità di build e TypeScript: le codebase dei pod operano in modalità TypeScript strict, senza eccezioni del compilatore permesse. Qualsiasi payload non tipizzato o asserzione debole di variabile blocca immediatamente la build.
-
Scansione di sicurezza e privacy dei dati: test di sicurezza statici automatizzati (SAST) esaminano le chiamate di event-tracking e i payload lato client. Le pipeline del pod devono superare controlli automatici di redazione PII per garantire che stringhe di email in chiaro, indirizzi IP o token di autorizzazione non aggirino mai le funzioni di hashing prima della trasmissione ai data lake di marketing analytics.
-
Il modello algoritmico di allocazione risorse 70/20/10
Per prevenire il "growth rot" — il graduale collasso della velocità di sprint provocato dal deterioramento del codice sperimentale — la capacità di sprint del pod deve essere regolata da un budget algoritmico di risorse anziché da priorità fluttuanti del backlog. I lead di engineering e marketing del pod ripartiscono la larghezza di banda su tre direttrici bloccate:
-
70% per esperimenti a impatto diretto sui ricavi: dedicato esclusivamente all'esecuzione guidata da ipotesi, incluse ottimizzazioni di funnel, percorsi di onboarding dinamici e scaglioni di prezzo localizzati.
-
20% per l'infrastruttura di sperimentazione: investito nel motore di crescita stesso — creazione di librerie di componenti modulari, potenziamento dell'orchestrazione di feature flag e ottimizzazione dei dispatcher di webhook di eventi n8n.
-
10% per la bonifica del debito tecnico: riservato rigorosamente all'igiene del codice. Al termine di ogni ciclo di due settimane, gli engineer eliminano le varianti perdenti, rimuovono i feature flag obsoleti e rifattorizzano gli esperimenti vincenti in moduli di componenti condivisi nel core.
-
Questa ripartizione operativa garantisce che i pod eseguano a velocità da startup senza generare passività a lungo termine per i maintainer della piattaforma enterprise.
Il blueprint di migrazione a 90 giorni: transizione da dipartimenti monolitici a unità pod
La transizione di un'organizzazione da dipartimenti funzionali a silos verso pod autonomi richiede di trattare la topologia aziendale come un refactoring di sistemi distribuiti. Implementare un'efficace Growth Team Architecture senza destabilizzare le pipeline di ricavi attive richiede un passaggio strutturato in tre fasi che rimuove sistematicamente le dipendenze tra strategia commerciale e core product engineering.
Fase 1 (Giorni 1–30): Isolamento della superficie e contratti di telemetria
La transizione ha inizio isolando un contesto circoscritto ad alto impatto all'interno del proprio motore di ricavi. Anziché stravolgere l'intero customer journey, si punta a una singola superficie ad alta velocità — come il funnel di onboarding PLG self-serve o il flusso di registrazione freemium.
-
Blindare l'organico dedicato: estrarre due full-stack engineer, un growth marketer e un data analyst dalla rotazione tradizionale degli sprint. Questa coorte risponde esclusivamente a un Growth Product Manager designato, proteggendola dai ticket di debito tecnico del prodotto core.
-
Stabilire contratti di telemetria immutabili: implementare la validazione JSON Schema all'edge per tutto il tracciamento degli eventi. Definendo contratti rigorosi per eventi come
trial_activatedoworkspace_invited, si eliminano le discrepanze di dati tra analytics client-side e database di produzione prima di avviare i test. -
Calibrazione delle metriche di baseline: consolidare i tassi di conversione di riferimento, la latenza di Time-to-Value (TTV) e le metriche di abbandono del funnel per questa singola superficie su un ciclo mobile di almeno 14 giorni.
-
Fase 2 (Giorni 31–60): Disaccoppiamento tecnico e deployment all'edge
I pod autonomi falliscono quando sono costretti a rilasciare tramite treni di release monolitici. La Fase 2 disaccoppia la superficie target dal repository dell'applicazione primaria per abilitare release in produzione in meno di un'ora.
-
Rilasciare l'architettura a microfrontend: disaccoppiare il flusso di onboarding utilizzando sub-applicazioni Next.js o Module Federation. Il growth pod deve possedere il proprio target di deployment front-end in modo indipendente dal runtime dell'applicazione principale.
-
Implementare analytics server-side: spostare gli script di tracciamento client-side verso un proxy di ingestione server-side (tramite edge worker o strumenti come RudderStack). Ciò aggira gli ad blocker, cattura il 100% dei dati di telemetria e abbatte l'overhead di esecuzione JavaScript client-side preservando Core Web Vitals sotto i 200ms.
-
Costruire pipeline CI/CD asincrone: distribuire workflow isolati di GitHub Actions che eseguono test end-to-end (E2E) automatizzati su ambienti di anteprima effimeri e dedicati, aggirando del tutto i gate di staging legacy.
-
Fase 3 (Giorni 61–90): Sperimentazione automatizzata e calibrazione economica
La fase conclusiva smantella definitivamente i passaggi di consegne basati su ticket tra marketing ed engineering, sostituendo le code Jira con workflow automatizzati definiti nel codice.
-
Automatizzare i loop di sperimentazione: distribuire workflow n8n integrati con SDK di feature flagging (come PostHog o LaunchDarkly). Il marketing definisce i parametri dell'esperimento all'interno di uno schema strutturato, attivando webhook automatizzati che creano feature flag per le varianti, contrassegnano automaticamente le coorti di analytics e allertano il pod al raggiungimento della significatività statistica.
-
Deprecare i passaggi di consegne funzionali: abolire i brief creativi interdipartimentali. Gli engineer del pod lavorano fianco a fianco con i marketer all'interno di branch edge condivisi, effettuando il commit di codice e testi delle varianti simultaneamente.
-
Calibrare le metriche di successo del Pod: spostare la valutazione del pod dalla velocità degli sprint di engineering o dal volume di lead di marketing. L'unico indice di performance del pod diventa l'accelerazione dell'ARR lordo e l'efficienza CAC:LTV — imponendo un periodo di recupero dell'acquisizione clienti (CAC payback period) compresso a meno di 8 mesi.
-
I silos dipartimentali sono un pattern architetturale fallimentare che deprime direttamente i margini lordi. Nel B2B SaaS moderno, la velocità non si misura nel conteggio dei commit o nelle impression delle campagne, ma nella rapidità deterministica con cui un'ipotesi operativa si converte in pipeline enterprise verificata. Riorganizzare la crescita in unità pod autonome elimina l'attrito organizzativo che tiene in ostaggio il vostro CAC. Se l'attuale interfaccia tra prodotto ed engineering sta frenando la crescita dell'ARR, è necessario riprogettare il sistema. Prenota un growth architecture audit completo per diagnosticare le vostre latenze operative e implementare strutture pod agentiche ad alto throughput.
Memo Strategici Correlati
Tutti i Memo →First-party data architecture for Meta and LinkedIn retargeting pixel optimization
Client-side retargeting is an architectural liability. Between browser-enforced storage restrictions, aggressive ad-blocking, and signal attenuation across e...
API gateway design: Consolidating microservices under unified authentication
Distributed systems frequently degrade into unmaintainable security liabilities when authentication logic is federated across autonomous microservices. In my...
Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.