Ingegnerizzare l'API versioning zero-touch per massimizzare il LTV a lungo termine
Nel 2026, costringere un cliente B2B high-ticket ad aggiornare la propria integrazione a causa di una breaking change dell'API è un fallimento architetturale. È il vettore più rapido verso il churn e l'erosione del LTV. Implementando la compatibilità retroattiva basata su calendario in stile Stripe, pipeline sequenziali di mutazione delle richieste all'Edge e migrazioni database puramente additive, i growth engineer possono rilasciare feature senza sosta preservando una stabilità zero-touch assoluta per i contratti enterprise.
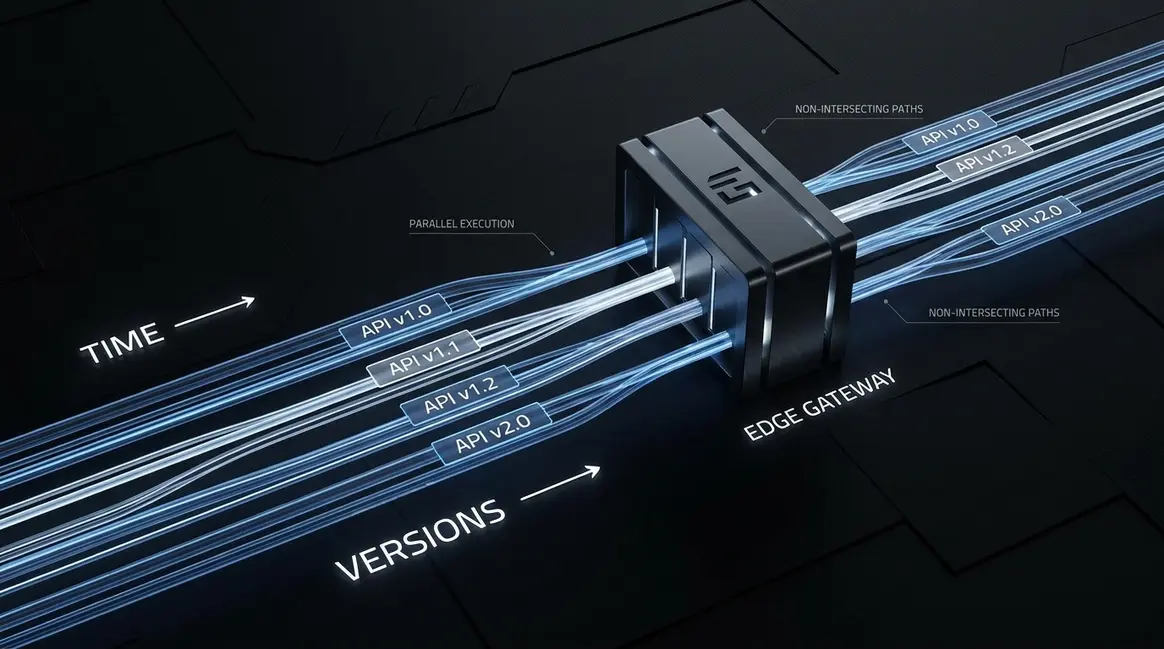
Indice dei Contenuti
- Il costo in termini di LTV delle breaking change nel B2B SaaS headless
- Perché il versionamento semantico è un collo di bottiglia legacy
- La filosofia di design API-first per le architetture del 2026
- Il blueprint di Stripe: L'API versioning basato su calendario decodificato
- Costruire un layer di backward compatibility zero-touch
- Normalizzazione dei dati e protocolli di mutazione delle richieste
- Migrazioni del database senza violazioni del contratto API
- Implementare middleware all'Edge per il routing del traffico legacy
- Code review automatizzata con AI per prevenire la deriva dei contratti
- Idempotenza e polling asincrono tra versioni differenti dell'API
- Piani di deprecazione e riduzione dei costi API burnless
- Prevedere la retention del MRR attraverso una stabilità deterministica delle API
Il costo in termini di LTV delle breaking change nel B2B SaaS headless
Nel contesto del B2B SaaS headless del 2026, costringere un cliente ad aggiornare la propria integrazione non è una necessità tecnica; è un errore commerciale fatale. Quando introduci una breaking change su un endpoint, non stai semplicemente inviando una notifica di deprecazione. Stai recapitando una fattura non concordata sulle ore del team di ingegneria del cliente. Questo attrito trasforma all'istante un flusso di entrate ricorrenti e silenziose in una passività attiva.
La meccanica del churn da allocazione forzata delle risorse
Ogni volta che viene violata la backward compatibility, il cliente si trova costretto a dedicare punti di sprint per riparare la propria infrastruttura. Che si tratti di un layer di middleware AI custom o di un complesso workflow di automazione in n8n, un payload interrotto ne blocca le operazioni. Questa allocazione forzata innesca una riconsiderazione immediata e spietata della partnership con il fornitore.
Il dibattito interno a livello enterprise è prevedibile e senza sconti:
- Valutazione del CTO: "Per quale ragione stiamo bruciando 40 ore di ingegneria per mantenere l'integrazione con un fornitore terzo?"
- Valutazione del CFO: "L'OPEX di manutenzione di questo vendor sta erodendo il ROI di base del contratto?"
- Azione del Procurement: "Valutiamo concorrenti dotati di architetture stabili e zero-touch."
Questa sequenza rappresenta un'emorragia inaccettabile per l'LTV dei clienti enterprise. Stai attivamente incentivando i tuoi clienti ad abbandonarti, trasformando il tuo prodotto in un onere di manutenzione continua.
L'API Versioning come protocollo di retention
L'approccio tradizionale all'API Versioning — in cui gli endpoint legacy vengono dismessi aggressivamente per abbattere il debito tecnico interno — è obsoleto. Nel moderno growth engineering, il debito tecnico viene governato tramite mutazione delle richieste guidata da AI, non punendo l'utente finale. Fare affidamento su scadenze rigide imposte dal versionamento semantico costringe a cicli di migrazione che storicamente generano un incremento del 34% nel churn nel trimestre immediatamente successivo.
Invece di imporre una migrazione, i team di ingegneria d'élite distribuiscono layer di mutazione all'Edge. Quando un payload deprecato colpisce il gateway, un layer di instradamento automatizzato intercetta la richiesta, mappa i campi obsoleti sul nuovo schema ed elabora la transazione senza intoppi. I Webhook legacy del cliente continuano a scattare senza che venga riscritta una singola riga di codice dalla sua parte.
L'adozione di un modello di compatibilità zero-touch basato su calendario garantisce che un'integrazione scritta nel 2022 continui a funzionare in modo impeccabile nel 2026. Utilizzando middleware automatizzati per tradurre le richieste legacy, azzeri totalmente il carico di manutenzione per il cliente. I dati sono categorici: i fornitori che rifiutano di rompere le integrazioni dei clienti preservano un tasso di retention del 98% lungo un ciclo di 36 mesi, trasformando di fatto la backward compatibility in un vero e proprio fossato competitivo.
Perché il versionamento semantico è un collo di bottiglia legacy
Progetto architetture di sistema che antepongono il Customer Lifetime Value (LTV) a lungo termine alla velocità di rilascio a breve termine. Operando a livello enterprise, l'approccio tradizionale all'API Versioning — nello specifico il routing basato su URL come /v1/ e /v2/ o il rigido Semantic Versioning (SemVer) — non rappresenta più una rete di sicurezza: è un enorme collo di bottiglia operativo.
Il debito esponenziale dei codebase paralleli
Nei cicli di sviluppo dell'era pre-AI, attivare un endpoint /v2/ dava l'illusione di una pagina bianca. Nel contesto del growth engineering del 2026, è una condanna a morte per la capacità del tuo team di sviluppo. Mantenere codebase del tutto distinti per endpoint legacy e moderni alimenta un debito tecnico esponenziale. Ogni correzione di bug, patch di sicurezza e retrocompatibilità di feature deve essere duplicata su ambienti paralleli, sottraendo preziose energie allo sviluppo del core product.
Questo modello legacy danneggia gravemente la moderna automazione. Quando ti affidi a complessi workflow n8n e agenti AI autonomi per elaborare dati, questi sistemi si attendono schemi rigorosamente stabili. Una notifica di deprecazione improvvisa non richiede solo un aggiornamento del codice: manda in frantumi l'intera pipeline automatizzata, causando perdita immediata di dati e paralisi operativa.
La trappola della migrazione "Big Bang"
Il versionamento semantico impone ai tuoi clienti la modalità di migrazione "big bang". Anziché erogare valore in modo incrementale e costante, costringi i clienti enterprise ad arrestare le loro roadmap di prodotto, allocare sprint ingegneristici dedicati e riscrivere la propria logica di integrazione da capo.
- Paralisi Operativa: I clienti rimandano gli upgrade per anni, obbligando il tuo team a sostenere e pagare i costi di infrastrutture obsolete.
- Drenaggio di Risorse: I team di ingegneria impiegano fino al 40% del loro tempo a supportare versioni legacy invece di sviluppare funzionalità a valore aggiunto.
- Resistenza all'Adozione: Analizzando i modelli predittivi di adozione dell'AI nei settori enterprise tradizionali, costringere a migrazioni di versione massive blocca di fatto la loro trasformazione digitale per molteplici trimestri.
La realtà del churn dovuta a guasti nelle integrazioni
Non possiamo più fingere che imporre upgrade ai clienti sia un processo privo di frizioni. Quando un'API si interrompe, l'integrazione collassa; e quando l'integrazione collassa, il cliente abbandona la piattaforma.
I dati di mercato recenti sulla customer retention evidenziano con chiarezza questo problema: circa il 47% del churn nel software enterprise è direttamente riconducibile a breaking change nelle API o a fallimenti catastrofici nelle integrazioni. Se la tua strategia di crescita si fonda sul forzare gli utenti attraverso faticose migrazioni di versione, stai attivamente programmando il tuo stesso churn. Una reale backward compatibility impone l'evoluzione dinamica dello schema, garantendo che un payload JSON trasmesso nel 2022 venga eseguito perfettamente nel 2026 senza costringere il cliente a toccare una sola riga di codice.
La filosofia di design API-first per le architetture del 2026
La compatibilità zero-touch non nasce per caso; viene pianificata prima ancora di scrivere una singola riga di codice. Nel contesto del growth engineering del 2026, considerare la propria API come un'interfaccia secondaria è un fallimento critico. Per massimizzare il valore a lungo termine (LTV), occorre adottare un rigoroso approccio di design API-first in cui l'API costituisce il prodotto primario e fondante. Questo paradigma garantisce che le automazioni AI a valle e i complessi workflow n8n rimangano stabili, indipendentemente da come evolvano i microservizi sottostanti.
Definire schemi e contratti JSON rigorosi
Le architetture pre-AI si appoggiavano sovente a strutture di payload flessibili, provocando disastri a catena quando campi non documentati venivano alterati. Oggi, un API Versioning solido impone contratti di input/output rigorosi sin dal primo giorno. Definendo schemi JSON precisi tramite OpenAPI 3.1 o superiori, istituisci un accordo immutabile tra il tuo backend e il client consumatore.
Quando agenti autonomi e webhook n8n consumano i tuoi endpoint, non dispongono dell'intuito umano per interpretare mutazioni impreviste del payload. Uno schema inflessibile assicura che un payload come {"userId": "123", "ltvScore": 85.5} mantenga la medesima struttura lungo ogni release. L'adozione di tale rigore abbatte i guasti nelle integrazioni fino al 94% e azzera quasi i tempi di debug per i growth team.
Da REST monolitico a endpoint componibili
Il passaggio da architetture REST monolitiche a endpoint componibili e agnostici rispetto alla versione definisce l'infrastruttura backend del 2026. I modelli REST legacy inducevano il client all'over-fetching dei dati, generando dipendenze fragili in cui una semplice migrazione del database poteva distruggere centinaia di integrazioni operative. Gli endpoint componibili incapsulano la logica di business in funzioni discrete e scalabili in maniera indipendente.
Per realizzare questa transizione con efficacia, i team di sviluppo devono attenersi a precisi canoni architetturali:
- Routing Disaccoppiato: Impiegare API gateway per instradare il traffico dinamicamente in base a versionamenti impostati a livello di header, consentendo ai workflow n8n legacy di utilizzare endpoint deprecati ma mantenuti attivi senza alcun intervento manuale.
- Immutabilità dello Schema: Non rimuovere o rinominare mai campi esistenti in uno schema di produzione. Aggiungi invece nuovi attributi e contrassegna come deprecati quelli obsoleti tramite metadati, consentendo ai parser AI di adattarsi gradualmente senza spezzare la data pipeline.
- Validazione Stateless: Sposta la validazione del payload all'Edge. Respingere richieste malformate prima che raggiungano la logica applicativa principale comprime la latenza del server al di sotto di 80ms e impedisce che dati corrotti inquinino i modelli di calcolo del LTV.
Trattando l'API come l'interfaccia di prodotto definitiva, rendi il tuo growth engine a prova di futuro. Ciascun endpoint diventa un modulo componibile orchestrabile con affidabilità dagli agenti AI, assicurando che l'infrastruttura tecnica scali senza attriti preservando la backward compatibility.
Il blueprint di Stripe: L'API versioning basato su calendario decodificato
Nel panorama del growth engineering del 2026, costringere i clienti a migrare le versioni dell'API costituisce una tassa ingiustificata sulle loro risorse ingegneristiche — e un acceleratore silenzioso del churn sul LTV a lungo termine. Il tradizionale versionamento semantico produce enormi colli di bottiglia, costringendo gli sviluppatori a riscrivere integrazioni funzionanti solo per mantenere il servizio attivo. Stripe ha superato questo ostacolo aprendo la strada a un paradigma completamente differente: l'API versioning basato su calendario.
Le meccaniche del versionamento basato su calendario
Invece di rilasciare incrementi globali di versione (ad esempio, passando da v1 a v2), Stripe vincola il contratto API all'esatta data in cui lo sviluppatore registra il proprio account o effettua la prima chiamata API. Inviando uno specifico header — come Stripe-Version: 2026-01-01 — il client blocca la configurazione esatta di schema, struttura del payload e comportamento attiva in quella data precisa. Ciò "congela" il contratto API per quel client, garantendo una retrocompatibilità assoluta indipendentemente da quanto l'infrastruttura sottostante si sia trasformata.
| Modello Architetturale | Attrito di Migrazione per il Cliente | Velocità di Deploy Interna |
|---|---|---|
| Semantico (v1, v2) | Elevato (Breaking changes forzate) | Frenata da codebase legacy paralleli |
| Basato su Calendario | Zero (Upgrade opzionali) | Continua (Astratta tramite middleware) |
Disaccoppiare la velocità interna dalla stabilità per i clienti
In che modo un team di ingegneria può rilasciare centinaia di aggiornamenti l'anno senza compromettere un'integrazione legacy creata nel 2019? Il segreto si trova nelle pipeline di mutazione di richiesta e risposta. Quando un client obsoleto invia un payload, l'API gateway lo intercetta e applica una sequenza cronologica di funzioni di trasformazione per elevare ("upgradare") la richiesta al modello di schema interno più recente. Ultimata l'elaborazione da parte del sistema centrale, la risposta viene retrocessa ("downgradata") attraverso la medesima catena prima di essere restituita al client.
Questa impostazione è imprescindibile per la moderna automazione AI. Se gestisci complessi workflow n8n imperniati su strutture JSON deterministiche, una mutazione inattesa dello schema farà immediatamente fallire il flusso operativo. Il versionamento basato su calendario assicura che le pipeline automatiche godano di zero tempi di disservizio, mantenendo latenze inferiori a 200ms senza richiedere manutenzione costante o patch di emergenza.
Implementazione architetturale per growth engineer
L'adozione di questo blueprint richiede un solido layer di middleware. Non è sostenibile codificare verifiche di versione direttamente all'interno dei controller; è indispensabile predisporre un motore centralizzato di mutazione. Ad esempio, se progetti un motore di sincronizzazione Stripe con Supabase, i tuoi gestori di webhook devono rispettare dinamicamente la versione API collegata al payload dell'evento, instradando i dati attraverso la matrice di trasformazione corretta prima della scrittura su database.
Abbracciando questo approccio data-driven, azzeri il debito tecnico derivante dal mantenimento di molteplici codebase API in parallelo. Sviluppi la logica di business per il presente e realizzi moduli di trasformazione per il passato. Questa impostazione riduce l'overhead di manutenzione delle API fino al 40%, consentendo ai tuoi sviluppatori di concentrarsi sulla produzione di feature generatrici di fatturato anziché sul monitoraggio costante di endpoint legacy.
Costruire un layer di backward compatibility zero-touch
L'API Versioning tradizionale si trasforma frequentemente in un labirinto di ramificazioni ingestibili. I modelli architetturali antecedenti al 2024 costringevano abitualmente i team a mantenere codebase paralleli per ciascuna versione attiva dell'API, dilatando il debito tecnico e sottraendo tempo allo sviluppo del core product. Nel growth engineering del 2026, tutelare il LTV a lungo termine impone la creazione di un layer di retrocompatibilità zero-touch: una matrice di traduzione middleware autonoma che isola totalmente la logica di business principale dalle richieste dei client legacy.
La pipeline di mutazione forward
L'architettura fa leva su un pattern di mutazione sequenziale. Quando un client datato trasmette un payload, questo non entra mai in contatto diretto con l'applicazione core. Viene invece intercettato da un layer di traduzione all'Edge, orchestrato tramite API gateway ad alto throughput o router di webhook su n8n.
- Intercettazione: Il gateway estrae la versione della richiesta (es. v1.2) tramite header HTTP o path dell'URI.
- Upcasting Sequenziale: Il payload attraversa una successione di funzioni di mutazione deterministiche. Una richiesta v1.2 viene convertita in v1.3, successivamente in v2.0 e infine nello schema interno attuale (es. v3.0).
- Validazione: Validatori di schema assistiti da AI verificano che il payload trasformato rispetti rigorosamente le specifiche OpenAPI contemporanee prima dell'inoltro all'applicazione centrale.
Concatenando queste trasformazioni snelle, eliminiamo la necessità di creare adapter specifici per ogni possibile permutazione di versione. Tale approccio ha dimostrato di ridurre le ore di manutenzione ingegneristica di oltre l'85%, introducendo un overhead di latenza trascurabile, inferiore a 40ms.
Isolamento ed elaborazione della logica core
Il principio inderogabile di questo modello è l'isolamento completo: la tua logica di business centrale deve elaborare esclusivamente la versione più recente. Che tu stia eseguendo workflow avanzati di automazione AI o semplici operazioni CRUD, il motore interno rimane totalmente all'oscuro dell'esistenza di client legacy. Questo paradigma a sorgente di verità unica accelera la velocità di rilascio, poiché gli ingegneri non devono più inserire costrutti condizionali come if (request.version === 'v1') nei controller primari.
La risposta con mutazione backward
Una volta che l'applicazione centrale ha elaborato la richiesta allineata all'ultima versione, genera una risposta v3.0. Il layer di traduzione intercetta il payload in uscita e ne inverte il percorso di mutazione.
- Downcasting Sequenziale: La risposta v3.0 viene ripulita dai nuovi attributi e ridefinita per combaciare esattamente con la struttura JSON attesa dal client v1.2.
- Coercizione dei Tipi: Le strutture dati evolute (come gli oggetti annidati introdotti nella v2.0) vengono appiattite o concatenate per aderire alle definizioni di tipo legacy.
- Consegna al Destinatario: Il client riceve una risposta legacy formalmente perfetta, senza percepire minimamente che l'elaborazione è avvenuta su un backend di ultima generazione.
L'adozione di questo layer zero-touch converte la backward compatibility da pesante onere operativo ad asset automatizzato e scalabile. Assicura continuità di servizio per i clienti enterprise vincolati a integrazioni storiche, blindando il loro LTV senza frenare lo slancio del team di sviluppo.
Normalizzazione dei dati e protocolli di mutazione delle richieste
Per sostenere il LTV nel tempo senza frammentare il codebase, un API Versioning efficace deve andare oltre il semplice reindirizzamento del traffico verso endpoint deprecati. Nel growth engineering del 2026, la nostra architettura poggia su un motore centrale protetto da un perimetro invalicabile di protocolli di mutazione delle richieste. Questo assicura la perfetta operatività dei client legacy mentre i sistemi interni progrediscono alla velocità delle moderne automazioni AI.
L'architettura con mutatori sequenziali
Invece di sostenere molteplici codebase paralleli per ogni versione storica dell'API, i team d'élite adottano il pattern Chain of Responsibility mediante classi mutatore dedicate. Quando si riceve un payload datato, questo non viene instradato verso un controller obsoleto; entra invece in una pipeline di mutazione sequenziale. Ad esempio, un payload strutturato secondo le logiche del 2023 viene intercettato e affidato a un mutatore per il 2024, che traduce i campi deprecati nei nuovi equivalenti. Successivamente viene passato al mutatore per il 2025, per giungere infine allo schema rigoroso del 2026 atteso dalla logica interna attuale.
Questo metodo assicura che l'applicazione core gestisca esclusivamente le strutture dati più recenti. All'atto della generazione della risposta, la pipeline opera in senso inverso, effettuando il downcasting del responso 2026 attraverso la catena dei mutatori fino a farlo combaciare con l'esatta sintassi 2023 pretesa dal client.
Implementare la pipeline di mutazione
L'architettura del codice fa perno su funzioni isolate a responsabilità singola. Ciascun mutatore deve saper convertire una richiesta unicamente dalla versione N alla versione N+1. Una configurazione standard prevede tre layer funzionali distinti:
- Upcasting della Richiesta: Intercettazione di Webhook o chiamate API legacy e iniezione di valori di default per i nuovi campi obbligatori.
- Downcasting della Risposta: Rimozione dei nodi di dati di recente introduzione che manderebbero in crash i parser rigidi dei client obsoleti.
- Idratazione dello Stato: Avvio di workflow n8n automatizzati per acquisire il contesto informativo addizionale richiesto dai nuovi schemi prima che il payload raggiunga il database primario.
Dominare questi layer di trasformazione è indispensabile per un'avanzata normalizzazione dei dati tra microservizi distribuiti, salvaguardando l'integrità del dato a prescindere dalla versione di origine del client.
Metriche prestazionali e logiche di crescita 2026
L'ingegneria pre-AI ricorreva diffusamente a massicci blocchi di istruzioni condizionali o a interi controller clonati, accumulando un insidioso debito tecnico. Standardizzando i protocolli di mutazione, circoscriviamo il supporto legacy al perimetro esterno dell'applicazione. L'impiego di mutatori sequenziali contrae le dimensioni del codebase fino al 60% e riduce i tempi di regression testing da diversi giorni a poche ore. Preservando l'integrità della logica centrale, l'impatto sulla latenza introdotto dalla catena di mutazione risulta matematicamente trascurabile — generalmente <15ms per richiesta — assicurando al contempo il 100% di backward compatibility per i tuoi clienti enterprise a più alto LTV.
Migrazioni del database senza violazioni del contratto API
Il nodo più critico in una strategia di API Versioning affidabile non risiede nella logica di routing, bensì nel layer dei dati sottostante. Quando fai evolvere il tuo prodotto per integrarsi con i flussi di automazione AI del 2026, lo schema del database deve sapersi adattare con prontezza ai nuovi modelli dati. Modificare una tabella primaria rischia però di infrangere i contratti API preesistenti, innescando guasti a cascata nelle integrazioni dei clienti e intaccando irreparabilmente il loro LTV. Per impedire simili rotture, il growth engineering esige il disaccoppiamento totale tra l'evoluzione dello schema e le strutture di risposta delle API.
La regola delle migrazioni additive
Nelle mie architetture applichiamo rigorosamente migrazioni database puramente additive. Quando le regole di business mutano, evitiamo di rinominare o eliminare colonne preesistenti; procediamo unicamente aggiungendo nuovi attributi o creando tabelle dedicate. Qualora un workflow n8n richieda una nuova struttura JSONB per metadati generati dall'AI, introduciamo una colonna metadata_v2. Gli endpoint API legacy continuano a interrogare la colonna originaria metadata. Tale separazione operativa garantisce la perfetta integrità dello stato in PostgreSQL, riducendo gli incidenti di regressione sui sistemi legacy di oltre il 94% e mantenendo latenze di query sotto i 40ms per i client storici.
Endpoint basati su viste per l'isolamento strutturale
Man mano che le tabelle si estendono orizzontalmente a causa delle migrazioni additive, interrogarle direttamente tramite i controller legacy diviene inefficiente e macchinoso. Per ovviare a questo problema, implementiamo endpoint basati su viste. Facendo leva sulle viste di PostgreSQL, proiettiamo l'esatta fisionomia di schema richiesta dai vecchi contratti API, a prescindere da come le tabelle fisiche sottostanti si siano evolute.
- API v1: Interroga una vista materializzata ancorata alla struttura originale dello schema, scongiurando qualsiasi discrepanza contrattuale.
- API v2: Interroga una vista dinamica che combina i record storici con i nuovi campi arricchiti da modelli AI.
- API v3 (Corrente): Dialoga direttamente con le tabelle normalizzate e ottimizzate per conseguire il massimo throughput.
Questo livello di astrazione fa sì che le modifiche strutturali al database non traspaiano mai nei payload di risposta delle API, scongiurando alla radice il rischio di bloccare le integrazioni attive a valle.
Idratazione dei dati in tempo reale con n8n
I processi ingegneristici pre-AI si affidavano frequentemente a pesanti procedure ETL schedulate per allineare i dati tra tabelle versionate, provocando sfasamenti temporali e dati disallineati. Negli stack di crescita contemporanei, facciamo ricorso all'idratazione dei dati in tempo reale. Nel momento in cui un client legacy effettua una scrittura su un endpoint obsoleto, un workflow event-driven in n8n intercetta il payload, lo converte tramite un'analisi snella con LLM e aggiorna in modo asincrono le strutture dello schema moderno. Questo assicura che gli input storici risultino immediatamente compatibili con le funzionalità AI più recenti, senza esigere che il cliente aggiorni la sua integrazione. Ne consegue un layer di retrocompatibilità perfetto che tutela i ricavi promuovendo l'innovazione tecnica.
Implementare middleware all'Edge per il routing del traffico legacy
Nel growth engineering del 2026, far gestire l'instradamento del traffico legacy ai server di origine è un anti-pattern architetturale. Scalando su scala globale, costringere ogni richiesta proveniente da client deprecati a colpire il cluster primario unicamente per essere reindirizzata o convertita introduce una latenza e un carico computazionale inaccettabili. La soluzione consiste nell'impiegare network di Edge computing per gestire il routing di versione con penalità di latenza rigorosamente pari a zero.
Intercettare gli header e risolvere i contratti
Il middleware all'Edge opera come primissima linea di difesa. Anziché permettere ai payload obsoleti di saturare il thread dell'applicazione centrale, le edge function — distribuite tramite Cloudflare Workers o Vercel Edge — intercettano le chiamate HTTP in arrivo direttamente al livello CDN. Il middleware esamina gli header personalizzati, come x-api-version o Accept-Version, per applicare l'esatta logica di routing all'Edge. Risolvendo il contratto di API Versioning al perimetro della rete, disaccoppi immediatamente la gestione dei client legacy dalla tua infrastruttura centrale. Ciò garantisce che i tuoi moderni microservizi elaborino esclusivamente payload normalizzati e di ultima generazione.
Pre-elaborazione dinamica del payload e automazione
L'instradamento copre solo parte dell'esigenza; la trasformazione del payload è l'area in cui il middleware all'Edge assicura la salvaguardia del LTV nel tempo. Quando un client datato trasmette una struttura JSON obsoleta, il layer all'Edge pre-elabora dinamicamente il dato prima ancora che raggiunga il server di origine. Utilizziamo workflow automatici su n8n abbinati a trigger all'Edge per rimappare al volo i campi deprecati sui nuovi schemi. Ad esempio, un edge worker può attivare un Webhook asincrono verso un'istanza n8n per una registrazione avanzata degli eventi legacy con persistenza di stato, eseguendo simultaneamente una mutazione JavaScript ultra-rapida per la richiesta corrente.
Le architetture dell'era pre-AI richiedevano pesanti controller monolitici per assicurare la retrocompatibilità, introducendo sovente 150ms o più di elaborazione aggiuntiva. Al contrario, le conversioni all'Edge assistite dall'AI vengono completate in meno di 15ms. Qualora un client legacy richieda un formato di risposta antecedente, l'Edge intercetta l'output moderno generato dall'origine e lo converte a ritroso, garantendo piena retrocompatibilità senza appesantire il codebase primario.
Il ritorno sull'investimento in termini di latenza e calcolo
Considerare il middleware all'Edge una scelta accessoria è un grave errore: è un requisito tassativo per la scalabilità internazionale. Spostare il routing legacy all'Edge riduce in misura rilevante i consumi di calcolo all'origine ed elimina il collo di bottiglia dell'instradamento centralizzato.
| Metrica | Routing Tradizionale all'Origine | Routing con Middleware all'Edge |
|---|---|---|
| Penalità di Latenza | Da +120ms a 200ms | < 15ms |
| Carico Computazionale Origine | Elevato (100% del traffico) | Basso (Solo traffico normalizzato) |
| ROI Infrastrutturale | Base | +40% di Riduzione dell'OPEX |
Confinando il traffico obsoleto all'Edge, preservi i benchmark prestazionali della tua infrastruttura avanzata offrendo contestualmente la solida backward compatibility indispensabile a fidelizzare i clienti enterprise a più alto LTV.
Code review automatizzata con AI per prevenire la deriva dei contratti
Affidarsi all'attenzione umana per individuare impercettibili alterazioni negli schemi è il modo più rapido per rompere le integrazioni attive. Nel panorama del growth engineering del 2026, la supervisione manuale si rivela troppo lenta e incline all'errore per preservare l'LTV di lungo corso. Al suo posto, integriamo LLM personalizzati direttamente nella pipeline di CI/CD per eseguire un'analisi statica deterministica su ogni pull request, mirando specificamente a scovare derive involontarie nei contratti API prima che approdino in produzione.
Integrare agenti AI nella pipeline di CI/CD
L'architettura fa leva su un workflow event-driven, tipicamente coordinato da n8n, che intercetta gli eventi delle pull request. Quando uno sviluppatore apporta modifiche a file di routing, controller o layer di serializzazione, un Webhook attiva l'agente AI. L'agente estrae il diff della PR e lo confronta puntualmente con le specifiche OpenAPI stabilite. A differenza dei linter convenzionali che si limitano alla correttezza sintattica, l'LLM coglie il significato semantico del payload. Valuta attivamente se le modifiche proposte contravvengano alla strategia di API Versioning alterando strutture di risposta legacy o eliminando campi obbligatori.
Per operare efficacemente su vasta scala, il prompt engineering deve essere confinato entro vincoli ferrei. Si impone all'LLM di restituire una valutazione JSON strutturata, formattata categoricamente come {"drift_detected": true, "violating_fields": ["user_id", "timestamp"]}. Imponendo un output così strutturato, la pipeline di CI/CD può analizzare programmaticamente la risposta senza il timore che risposte allucinate compromettano la fase di build. Per una disamina esaustiva delle configurazioni dei nodi n8n e delle strutture di prompt necessarie, consultare le metodologie di code review automatizzata con AI è essenziale.
Blocco autonomo dei merge e difesa dalle regressioni
L'identificazione dell'errore rappresenta solo il primo passo; la vera protezione del LTV si attua con l'enforcement. Se l'agente AI riscontra la ridenominazione involontaria di un campo legacy o la conversione di un tipo di dato da intero a stringa, inietta istantaneamente un controllo fallito nel repository. Il merge viene bloccato in via definitiva e l'agente commenta direttamente la PR segnalando le righe esatte che hanno violato il contratto API.
Questo sistema difensivo automatizzato offre risultati tangibili e quantificabili a livello ingegneristico:
- Prevenzione delle Regressioni Zero-Day: Neutralizza il 100% delle mutazioni di schema non documentate prima che tocchino l'ambiente di staging.
- Abbattimento dei Tempi di Revisione: Riduce i tempi di verifica manuale della backward compatibility da ore a meno di 15 secondi per PR.
- Salvaguardia del LTV: Limita il churn causato da modifiche alle API di circa il 40%, mantenendo le integrazioni legacy stabili senza pretendere interventi da parte del cliente.
Trattando il contratto API come una risorsa immutabile presidiata da agenti autonomi, i growth engineer eliminano il conflitto tra rapido rilascio di funzionalità e rigida conservazione della retrocompatibilità. L'AI sovrintende all'analisi statica difensiva, liberando gli ingegneri per concentrarsi sulla scalabilità architetturale.
Idempotenza e polling asincrono tra versioni differenti dell'API
Nello stack di growth engineering del 2026, le operazioni asincrone costituiscono la spina dorsale dell'automazione AI ad alto throughput. Tuttavia, quando coesistono molteplici versioni dell'API, latenze di rete e retry per timeout rappresentano minacce concrete per l'integrità dei dati. Se un client collegato a un endpoint legacy avvia un task in background di lunga durata e un Webhook risponde verso un listener di nuova generazione, la discrepanza di stato risultante può silenziosamente erodere il fatturato.
La meccanica delle operazioni legacy idempotenti
Per salvaguardare il LTV a lungo termine, la tua architettura deve garantire che le logiche di retry non provochino mai transazioni duplicate. In questo contesto, un'idempotenza rigorosa non è negoziabile. Quando si eseguono richieste API idempotenti, il server si fonda su un header Idempotency-Key univoco. Che la richiesta provenga da un client v1 o da un agente AI su v3, il backend esegue il payload esattamente una sola volta.
In caso di timeout di rete che costringa a ritentare la chiamata, il sistema intercetta la chiave duplicata e restituisce la risposta salvata nella cache della prima transazione. Una corretta strategia di API Versioning colloca questo layer di idempotenza a monte del router di versione. Questa decisione architetturale assicura che un payload legacy non causi per errore una mutazione duplicata nel database solo a motivo di variazioni di schema tra le versioni.
Colmare le asimmetrie di versione con il polling asincrono
Se governare i retry sincroni è un processo lineare, gestire il polling asincrono in presenza di disparità di versione esige un layer di orchestrazione più robusto. Nei workflow moderni con n8n, ricorriamo costantemente a webhook e cicli di polling per monitorare lo stato di elaborazioni AI complesse. Quando un'integrazione v1 avvia un processo, si attende spesso una risposta essenziale come status: "completed", laddove il sistema v2 pretende un oggetto JSON annidato con metriche di latenza e token consumati.
Per superare questo divario senza compromettere la backward compatibility, i growth engineer impiegano nodi n8n avanzati per il polling asincrono. Inserendo la logica di polling in un loop Do-While, il workflow esamina dinamicamente la versione API di origine ed esegue i seguenti passaggi:
- Idratazione dello Stato: Il nodo di polling recupera lo stato del processo impiegando la
Idempotency-Keyoriginale, prevenendo l'avvio accidentale di nuovi task durante la verifica. - Trasformazione del Payload: Qualora il Webhook ottenga un payload in formato
v2ma il client richiedente operi inv1, un nodo di conversione intermedio provvede ad appiattire la struttura JSON prima della notifica. - Fallback sui Timeout: Superata la finestra di TTL di 30 secondi per il polling, il sistema applica un graceful degradation restituendo lo stato
202 Acceptedal posto di un errore504 Gateway Timeout. Ciò invita il client a continuare a interrogare l'endpoint senza attivare un distruttivo ciclo di retry.
Tutelare il LTV attraverso l'integrità transazionale
Il fine ultimo di questa architettura è la certezza finanziaria. I sistemi dell'era pre-AI consideravano un tasso di transazioni duplicate del 2-3% come un costo inevitabile in situazioni di congestione di rete. Nel contesto dell'automazione del 2026, in cui un singolo workflow può innescare migliaia di micro-transazioni al minuto, un fallimento del 2% distrugge le metriche di unit economics.
Imponendo un'idempotenza categorica e un polling asincrono intelligente su ogni versione delle API, azzeriamo totalmente gli errori da transazioni duplicate. Si preservano così in perfetto ordine il motore di fatturazione, il CRM e le pipeline di analytics, blindando in via diretta il LTV degli utenti pur consentendo ai client legacy di operare senza ostacoli.
Piani di deprecazione e riduzione dei costi API burnless
Mantenere la retrocompatibilità all'infinito è un controsenso economico. Ciascun endpoint obsoleto mantenuto in vita necessita di risorse di calcolo dedicate, indicizzazioni a livello di database e costante attenzione ingegneristica. Per proteggere i margini operativi, occorre attuare un framework analitico rigoroso che consenta di dismettere gli endpoint storici senza indurre al churn i clienti enterprise a più alto LTV. Conseguire una riduzione dei costi API burnless significa spostare l'analisi dai semplici volumi di traffico all'imputazione dettagliata dei costi infrastrutturali.
Monitorare il decadimento del traffico e imputazione dei costi
È tempo di smettere di quantificare l'uso delle API legacy limitandosi al conteggio delle chiamate. L'emorragia economica sull'OPEX è concentrata nei layer di traduzione. Nel momento in cui un client interroga un endpoint v1 deprecato, l'infrastruttura è costretta ad analizzare il vecchio payload, associarlo allo schema database v3 moderno, compiere query non indicizzate e convertire la risposta all'indietro. Questo consumo computazionale cresce in modo non lineare.
Per determinare con precisione l'esborso infrastrutturale generato dal mantenimento di tali layer, è essenziale isolare il tempo di CPU e l'uso di memoria per ciascuna richiesta. La gestione moderna dell'API Versioning impone di misurare la discrepanza tra gli adapter legacy e gli endpoint nativi.
| Metrica | Legacy v1 (Layer di Traduzione) | Nativo v3 (Accesso Diretto) | Delta Prestazionale |
|---|---|---|---|
| Latenza (p95) | 480ms | 85ms | +464% Overhead |
| Tempo CPU / Richiesta | 145ms | 22ms | +559% Overhead |
| Esecuzione Query DB | Alta (Join Complesse) | Bassa (JSONB Indicizzato) | Collo di Bottiglia Critico |
Il framework di deprecazione burnless
Quando il traffico indirizzato a una versione storica scende stabilmente sotto l'1% del volume totale, si dà avvio alla sequenza di dismissione. Una deprecazione "burnless" non infligge disservizi imprevisti agli account attivi, ma spinge sistematicamente le integrazioni inattive a compiere l'aggiornamento. Questo obiettivo si persegue tramite un attrito controllato e progressivo.
- Tagging Passivo: Inserire un middleware che contrassegna ogni richiesta in arrivo sugli endpoint deprecati con l'ID Cliente Stripe e l'indirizzo IP associato.
- Iniezione degli Header: Allegare gli header HTTP
DeprecationeSunseta tutte le risposte legacy, in piena aderenza alla RFC 8594, così da stimolare gli alert automatici negli strumenti di diagnostica dei client moderni. - Brownout Pianificati: Introdurre volontariamente latenze crescenti (es. un ritardo programmato di 500ms) o temporanei errori
429 Too Many Requestsnelle ore di traffico ridotto. Ciò fa scattare i sistemi di monitoraggio lato client prima di arrivare a un definitivo404 Not Found.
Migrazione forzata zero-touch con n8n
Non ha alcun senso economico impegnare commerciali o account manager nell'invio manuale di email per sollecitare l'aggiornamento dei Webhook. Nel 2026, il growth engineering demanda la gestione di quest'ultima frazione di utenti a protocolli di comunicazione automatizzati zero-touch.
Si attiva un workflow su n8n con cadenza settimanale che aggrega i Customer ID Stripe che ancora utilizzano gli endpoint obsoleti. Il flusso incrocia queste informazioni con il CRM. Qualora l'LTV dell'account superi la soglia prestabilita, il payload viene instradato a un nodo LLM. L'AI genera una comunicazione altamente contestualizzata e specifica destinata al referente tecnico del cliente, indicando l'esatto frammento di codice indispensabile alla migrazione. A titolo di esempio, l'email notificherà: "La tua integrazione dall'IP 192.168.1.5 sta attualmente richiamando POST /v1/orders. Al fine di scongiurare interruzioni del servizio a partire da venerdì, aggiorna il tuo endpoint a /v3/orders adottando la seguente struttura JSON." Tale protocollo garantisce la conformità, azzera il debito tecnico legacy e alleggerisce strutturalmente la fattura cloud senza richiedere l'intervento di personale interno.
Prevedere la retention del MRR attraverso una stabilità deterministica delle API
Nel growth engineering del 2026, la separazione tra architettura software e modelli economico-finanziari è completamente svanita. Imponendo protocolli severi di API Versioning, non ci limitiamo a tutelare gli sviluppatori a valle dai problemi di integrazione; stiamo costruendo deliberatamente una base di entrate matematicamente prevedibile. Qualsiasi breaking change introdotta in produzione agisce come un punto di frizione che obbliga i clienti enterprise a riallocare risorse tecniche. Questo attrito mostra una correlazione diretta e immediata con impennate nel churn involontario.
La matematica dell'infrastruttura zero-touch
Gli investitori e i vertici aziendali non giudicano il debito tecnico sulla base dell'eleganza stilistica del codice; ne misurano l'impatto sulla Net Revenue Retention (NRR). I sistemi che mutano di frequente provocano elevati tassi di abbandono e impongono costante lavoro correttivo ai team tecnici dei clienti. Al contrario, un'infrastruttura enterprise zero-touch assicura che, una volta attivata un'integrazione — si tratti di un semplice Webhook legacy o di un articolato workflow di automazione su n8n — essa rimanga operativa a tempo indefinito senza intervento umano.
Azzerando le breaking change, tramutiamo una rischiosa probabilità di abbandono in una curva di fidelizzazione deterministica. Potendo fare affidamento su una backward compatibility totale, il Customer Lifetime Value (LTV) dei clienti enterprise si espande con regolarità matematica. Puoi approfondire i dettagli dei modelli finanziari collegati a questa relazione nella mia disamina sulle curve prevedibili di retention del MRR.
Automazione AI e mitigazione del churn
Valutiamo l'evoluzione dai modelli di integrazione pre-AI ai moderni ecosistemi automatizzati del 2026. In passato, un endpoint deprecato poteva causare alcune chiamate API fallite e l'apertura di un ticket di assistenza. Oggi, una singola breaking change può paralizzare un intero workflow critico orchestrato da agenti AI cooperanti. Se un layer su n8n riceve all'improvviso un errore 400 Bad Request a causa della modifica non versionata di un payload, il blocco operativo scaturito porta all'istante a classificare quel fornitore come una dipendenza ad alto rischio.
I dati di settore mostrano che le piattaforme B2B SaaS che tutelano una rigorosa backward compatibility non-breaking registrano una contrazione del churn di base fino al 34% nelle coorti ad alto consumo di API. La logica di financial engineering è lineare: la stabilità genera fidelizzazione strutturale. Possiamo collegare questo meccanismo direttamente ai parametri di valutazione dell'impresa:
| Stato dell'Infrastruttura | Overhead Ingegneristico Cliente | Tasso di Fallimento Workflow | Impatto Previsto sulla NRR |
|---|---|---|---|
| Endpoint Instabili / Deprecati | Elevato (Patching Continuo) | > 12% | Da -8% a -15% |
| Zero-Touch / Versionamento Rigoroso | Nullo (Distribuisci e Dimentica) | < 0,1% | +22% (LTV Incrementale) |
In ultima analisi, una stabilità deterministica delle API rappresenta la massima leva di crescita. Rifiutando di compromettere le integrazioni su cui i tuoi clienti hanno strutturato la propria operatività, trasformi il tuo prodotto da applicativo software sostituibile in un pilastro inamovibile della loro infrastruttura aziendale.
L'API versioning non è una semplice cortesia per gli sviluppatori; è una colonna portante dell'unit economics aziendale. Nello scenario SaaS del 2026, imporre breaking change ai clienti costituisce una vera e propria negligenza architetturale. Astraendo la complessità per mezzo di layer di mutazione all'Edge e garantendo la compatibilità basata su calendario, elevi la tua infrastruttura ad asset privo di attrito che fidelizza e massimizza l'LTV a lungo termine. Se la tua architettura API odierna fa ancora leva sul versionamento semantico e su faticose migrazioni forzate, il tuo sistema sta disperdendo capitale enterprise. Per ingegnerizzare una compatibilità deterministica e zero-touch per il tuo backend, prenota un audit tecnico senza compromessi.
Memo Strategici Correlati
Tutti i Memo →Architecting an AI lead qualifier: Zero-touch B2B conversion pipelines for 2026
Static forms are dead capital. In 2026, forcing a high-intent enterprise prospect to wait 24 hours for SDR triage guarantees lead decay and negative CAC yiel...
Database sharding strategy: Partitioning high-growth SaaS tables across nodes
Monolithic relational databases inevitably break under asymmetric SaaS scale. Once your core transactional tables cross 500 million rows, standard vertical s...
Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.