La fine del cost monitoring passivo: Architettare circuit breaker real-time per le API
Nel 2026, affidarsi a dashboard di fatturazione elaborate in batch ogni 24 ore è una passività ingegneristica catastrofica. I workflow di AI agentica e i microservizi disaccoppiati possono...
Indice dei Contenuti
- La trappola di latenza delle dashboard di fatturazione legacy
- Intercettare la telemetria a livello dell'Edge
- Rilevamento delle anomalie vettoriali per l'utilizzo dei token
- Elaborazione asincrona dei flussi di dati FinOps
- Esecuzione zero-touch: Revoca automatizzata delle chiavi API
- Imporre la normalizzazione dei dati tra provider esterni
- Instradare gli avvisi critici attraverso canali headless
- Quantificare l'impatto sull'MRR dei controlli deterministici dei costi
- Audit della vulnerabilità attuale ai picchi di utilizzo
La trappola di latenza delle dashboard di fatturazione legacy
Affidarsi ad AWS Cost Explorer, ai moduli di billing di Datadog o ai consueti avvisi di utilizzo di Stripe per le architetture del 2026 è la via certa verso un'emorragia finanziaria. Il nodo critico risiede nella fallacia dell'elaborazione batch. I moduli di fatturazione legacy si basano su cron job lenti che aggregano i dati a intervalli compresi tra 1 e 24 ore. Nel momento in cui scatta un avviso standard per un'impennata di spesa sulle API, il danno economico è ormai irreversibilmente registrato a bilancio. Un efficace Cost Monitoring non può più poggiare su una rendicontazione finanziaria post-facto: esige un'intercettazione istantanea al livello della rete.
La Meccanica delle Bruciature Incontrollate di Token
Nelle architetture pre-AI, la scalabilità dell'infrastruttura era sostanzialmente lineare. Un picco di traffico si traduceva nell'attivazione di qualche istanza EC2 supplementare, comportando un rincaro prevedibile e gestibile. Nei flussi di lavoro di automazione AI del 2026, i costi scalano in maniera esponenziale sulla base della complessità del payload e del comportamento degli agenti autonomi. Un singolo workflow n8n mal configurato che generi un loop ricorsivo di Webhook può scatenare migliaia di invocazioni LLM al minuto.
Si consideri lo scenario in cui un agente automatizzato di customer care rimane intrappolato in un loop di retry contro un endpoint API che genera risposte allucinate. A un ritmo di consumo di 120.000 token al minuto con modelli di fascia alta, la latenza del tuo stack di monitoraggio determina direttamente l'entità della tua perdita economica.
| Architettura di Monitoraggio | Latenza dell'Allarme | Token Bruciati (Loop Ricorsivo) | Impatto Finanziario (LLM High-Tier) |
|---|---|---|---|
| AWS Cost Explorer (Cron) | 24 Ore | ~172.8 Milioni | Catastrofico ($10k+) |
| Modulo Billing Datadog | 1 Ora | ~7.2 Milioni | Grave ($400+) |
| Circuit Breaker Event-Driven | < 200ms | < 500 | Trascurabile ($0.01) |
Passare a Flussi di Eventi Infrastrutturali in Tempo Reale
Per sopravvivere nell'era degli agenti autonomi, i team di ingegneria devono abbandonare le dashboard finanziarie differite e intercettare il layer dati grezzo. Ciò comporta la migrazione della telemetria dalle API di billing elaborate in batch a flussi di eventi infrastrutturali in tempo reale.
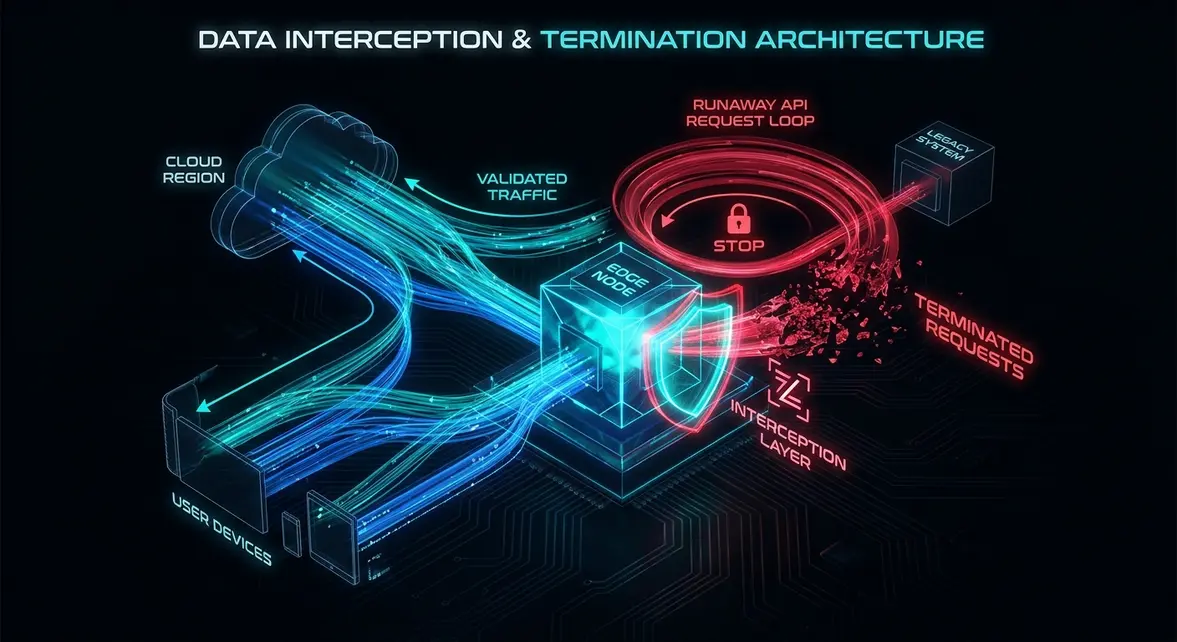
Invece di attendere che il provider cloud calcoli la spesa giornaliera, le architetture moderne impiegano worker posizionati all'Edge per tracciare il consumo di token e i volumi delle chiamate API direttamente in memoria, utilizzando archivi veloci come Redis. Nel momento in cui viene oltrepassata una soglia predefinita — ad esempio un balzo del 400% nelle chiamate API lungo una finestra rolling di 60 secondi — un Webhook automatizzato fa scattare istantaneamente il protocollo di circuit breaker. Questo arresta il processo anomalo e allerta l'ingegnere reperibile con una latenza inferiore a 200ms. L'adozione di questo modello event-driven costituisce il fondamento delle moderne strategie di Cloud FinOps, assicurando che la spesa anomala venga neutralizzata prima ancora di raggiungere il reparto amministrativo.
Intercettare la telemetria a livello dell'Edge
Nel 2026, affidarsi al database dell'applicazione core per registrare l'utilizzo delle API è un anti-pattern architetturale. Quando elabori migliaia di richieste LLM al minuto, convogliare la telemetria attraverso il thread principale genera strozzature gravissime. Per strutturare un framework di Cost Monitoring resiliente, devi intercettare i dati di consumo prima ancora che sfiorino la tua infrastruttura primaria.
Cloudflare Workers come Proxy Intelligente
Il mio framework poggia sull'implementazione di Cloudflare Workers quali proxy intelligenti a bassissima latenza. Anziché attendere che il server centrale analizzi il payload, il worker all'Edge intercetta la richiesta in ingresso ed estrae tre dati cardine: le dimensioni esatte della richiesta, l'endpoint di destinazione e l'ID del tenant. Raccogliendo questi metadati sul perimetro della rete, quantifichiamo immediatamente il peso economico della transazione. Questo dato viene poi raggruppato in batch e inviato in modo asincrono ai nostri Webhook di automazione su n8n, scavalcando del tutto il database principale.
Disaccoppiare la Telemetria dal Thread Principale
I sistemi legacy collegano tipicamente l'esecuzione della richiesta con la scrittura dei log; ciò fa sì che un'impennata improvvisa di traffico API sovraccarichi parallelamente le operazioni di scrittura sul database. Spostare la telemetria all'Edge impedisce al thread principale dell'applicazione di soccombere sotto carichi elevati. Nelle nostre implementazioni, delegare questo onere ha ridotto la latenza dei server core a <40ms, cancellando i deadlock del database durante i picchi di traffico. Per esaminare nel dettaglio la logica di routing, consulta le mie annotazioni sul deployment di edge middleware per la gestione di flussi di eventi ad alto volume.
Caching Leggero per il Controllo Immediato dello Stato
Raccogliere i dati è solo un lato della medaglia: per scongiurare spese incontrollate occorre intervenire in tempo reale. Ciò richiede un layer di caching snello all'Edge per custodire gli stati dei rate limit. Tramite Cloudflare KV o Durable Objects, il worker conserva un computo aggiornato del consumo di token per ciascun tenant ID.
- Rifiuto Immediato: Se un tenant oltrepassa la soglia dinamica, il worker all'Edge respinge la richiesta con codice
429 Too Many Requestsprima che generi alcun costo computazionale di backend. - Notifiche Asincrone: Il worker attiva simultaneamente un workflow n8n per avvisare il team tecnico su Slack, circostanziando l'anomalia di spesa.
- Validazione a Latenza Zero: Le verifiche sullo stato avvengono in meno di 5ms, garantendo che il traffico legittimo non subisca alcun rallentamento.
Questo approccio edge-first converte un logging passivo in un firewall finanziario proattivo, garantendo che i picchi imprevisti di spesa API vengano neutralizzati al livello della rete prima che intacchino le tue spese operative.
Rilevamento delle anomalie vettoriali per l'utilizzo dei token
Affidarsi a tetti di spesa statici per le API è una pratica superata che cede sotto l'impatto della scalabilità degli LLM. Nella growth engineering del 2026, soglie inflessibili finiscono per penalizzare i picchi d'uso legittimi o non riescono a intercettare dispersioni fraudolente di token se non a fine mese. Il passaggio a un rilevamento dinamico delle anomalie guidato dall'AI muta radicalmente il Cost Monitoring. Invece di semplici rate limit fissi, mappiamo i pattern ordinari di utilizzo di ciascun tenant all'interno di uno spazio multidimensionale per stabilirne la baseline comportamentale.
Mappare il Comportamento dei Tenant con Supabase e pgvector
Per attuare questa strategia, sfruttiamo pgvector all'interno di Supabase. Ogni interazione con le API viene convertita in un embedding vettoriale che esprime i metadati della chiamata. Non ci limitiamo a registrare il mero conteggio dei token: colleghiamo molteplici dimensioni per delineare una firma comportamentale accurata. I parametri tracciati nello spazio vettoriale comprendono:
- Rapporto Token-Latenza: Identificazione del costo computazionale per singolo token generato.
- Velocità degli Endpoint: Frequenza delle chiamate dirette a specifici endpoint LLM ad alto costo.
- Raggruppamento Temporale: Pattern di fruizione per fascia oraria e giorno della settimana.
- Utilizzo della Context Window: Dimensione media del payload in ingresso rispetto ai dati storici.
Raggruppando questi vettori in cluster, otteniamo una formulazione matematica del comportamento "normale" per ogni singolo tenant. Un utente standard che interroga una pipeline RAG genera costantemente vettori che si addensano in uno specifico quadrante. Questa baseline viene costantemente aggiornata mediante workflow su n8n che processano i log giornalieri, facendo sì che il modello si adatti alla crescita organica senza sollevare falsi positivi.
Scatenare Avvisi sulle Deviazioni Vettoriali
L'efficacia reale di questa architettura si palesa durante le impennate impreviste. Quando un'ondata anomala di richieste investe il sistema, viene seduta stante vettorizzata e confrontata con il cluster storico del tenant tramite similarità coseno. Se una chiave compromessa o uno script impazzito produce un aumento del 4000% nelle chiamate a endpoint ad alta intensità di calcolo, il vettore ricavato si collocherà ben lontano dal cluster abituale.
Poiché la distanza tra il nuovo vettore e la baseline storica eccede la nostra soglia dinamica, il sistema classifica immediatamente la richiesta come anomalia. Questo fa scattare all'istante un Webhook verso il layer di automazione su n8n, il quale provvede autonomamente a revocare la chiave API, avvisare il team di ingegneria e arrestare l'emorragia di token in meno di 200ms. L'integrazione di questi framework di osservabilità AI tutela l'infrastruttura da esplosioni incontrollate nei costi degli LLM, trasformando le operation da audit retrospettivi a una difesa algoritmica e proattiva.
Elaborazione asincrona dei flussi di dati FinOps
Tentare di calcolare il consumo di token e verificare i limiti di spesa in modo sincrono all'interno del ciclo di vita primario delle chiamate API è un errore architetturale imperdonabile. In ambienti ad alto throughput, aggiungere anche soli 40ms di ritardo per registrare la telemetria degrada la user experience e crea colli di bottiglia sui sistemi centrali. Un Cost Monitoring efficace impone una separazione rigorosa e asincrona, in cui i dati telemetrici vengono scaricati all'istante, preservando tempi di risposta inferiori a 200ms per gli endpoint rivolti agli utenti.
Disaccoppiare la Telemetria tramite Code all'Edge
Per sostenere volumi imponenti di chiamate API senza intaccare le prestazioni, devi disporre di un layer intermedio di message broker. A seconda dell'infrastruttura, ciò si concretizza nell'impiego di code Redis per ambienti containerizzati stateful, oppure nell'adozione di Cloudflare Queues per architetture edge-native distribuite. Al completamento di una chiamata API, il sistema emette semplicemente un evento non bloccante contenente i metadati di utilizzo (modello, token consumati e user ID) verso la coda.
Inoltrando questo flusso, il server principale chiude all'istante la connessione con il client. Il gravoso compito dell'aggregazione dati viene delegato a worker in background. Nel destreggiarsi tra architetture distribuite, padroneggiare la logica di scalabilità di edge function e code con cron è vitale per conservare un'alta disponibilità tracciando la unit economics al millimetro.
Valutazione Asincrona delle Soglie di Spesa
Una volta parcheggiata la telemetria in coda, i worker consumer elaborano i lotti in maniera del tutto asincrona. È in questo frangente che la logica finanziaria viene eseguita, senza contendere risorse alle API primarie. Il worker porta a termine le seguenti operazioni:
- Esegue il parsing dei token consumati a partire dal payload dell'evento in coda.
- Incrocia lo specifico modello LLM con una matrice di pricing dinamica per calcolare il costo esatto al centesimo.
- Aggrega la spesa sulla finestra temporale mobile corrente (es. gli ultimi 5 minuti).
- Confronta l'ammontare complessivo con le soglie di anomalia preimpostate.
Attivare il Motore Decisionale
Qualora il worker in background constati che la spesa rolling ha infranto la soglia ammessa, non si limita ad annotare un errore passivo nei log. Trasmette seduta stante un payload ad alta priorità al livello di automazione. Nello stack del 2026, ciò si traduce nell'invio di un JSON strutturato — come {"event": "spend_spike", "cost": 45.20, "window": "5m"} — direttamente a un Webhook n8n.
Questa impostazione assicura che l'applicazione core resti totalmente immune dal sovraccarico analitico del tracciamento FinOps, garantendo al contempo al motore decisionale su n8n un'informazione azionabile nell'esatto millisecondo in cui l'anomalia finanziaria trova conferma.
Esecuzione zero-touch: Revoca automatizzata delle chiavi API
Il Cost Monitoring passivo è un reperto dell'infrastruttura legacy. Nella growth engineering del 2026, rilevare un picco di consumo senza un kill switch automatizzato equivale a osservare passivamente la cassa bruciare in tempo reale. Il pilastro dei moderni meccanismi di circuit breaker si regge integralmente sull'esecuzione zero-touch, escludendo la latenza umana dal circuito di mitigazione.
Il Layer di Orchestrazione Headless
Per realizzare una mitigazione autonoma, implementiamo n8n quale layer di orchestrazione headless costantemente in ascolto dei superamenti delle soglie critiche. Invece di affidarsi a cron job che elaborano dati in batch, questa architettura sfrutta Webhook event-driven azionati direttamente dall'API gateway o dallo stack di telemetria. Al manifestarsi di un picco volumetrico, il sistema scavalca la consueta notification fatigue. Non si limita a inviare una mail o un messaggio Slack: avvia all'istante una sequenza deterministica per neutralizzare il rischio. Per assicurare che questo livello mantenga un'elevata disponibilità durante un'offensiva volumetrica, la predisposizione di severi guardrail di affidabilità per agenti n8n è uno standard produttivo imprescindibile.
Interruzione dell'Autenticazione in Millisecondi
La priorità tecnica immediata è arrestare l'emorragia all'Edge. Nel momento esatto in cui l'infrazione della soglia viene certificata, n8n esegue un comando diretto al database per invalidare le sessioni attive del tenant responsabile. A seconda dello stack in uso, ciò comporta il lancio di una query UPDATE per contrassegnare le chiavi API come inattive in PostgreSQL, o l'invio di un comando DEL a un cluster Redis per revocare all'istante i token JWT memorizzati in cache.
- Rifiuto all'Edge: Le richieste successive vengono respinte al livello di autenticazione in una manciata di millisecondi, impedendo che raggiungano gli onerosi endpoint LLM a valle.
- Sincronizzazione dello Stato: L'evento di revoca viene propagato allo strato di cache, facendo sì che i nodi edge globali riconoscano i token invalidati senza dover interrogare il database centrale.
Modifica Finanziaria tramite API Stripe
Parallelamente, il workflow provvede a congelare lo stato di fatturazione per evitare contestazioni o fatture spropositate. Il flusso n8n trasmette una chiamata REST diretta all'API di Stripe, selezionando lo specifico customer ID. Modificando lo stato della sottoscrizione in pause_collection, il sistema blocca ogni conteggio economico. Questo duplice intervento — revoca dell'accesso tecnico e congelamento dello stato finanziario — assicura un contenimento assoluto.
| Metrica di Mitigazione | Processo Manuale Pre-AI (2023) | Automazione Zero-Touch (2026) |
|---|---|---|
| Tempo di Revoca | 15 - 45 minuti | < 200ms |
| Esposizione Finanziaria | Illimitata durante la risposta | Rigidamente bloccata alla soglia |
| Overhead Ingegneristico | Elevato (Affaticamento da reperibilità) | Zero (Esecuzione autonoma) |
Imporre la normalizzazione dei dati tra provider esterni
Nelle architetture di growth engineering del 2026, fare perno su un unico fornitore AI è un evidente punto di debolezza. Smistiamo le chiamate dinamicamente tra OpenAI, Anthropic, AWS e Twilio per ottimizzare latenza e qualità dell'output. Tuttavia, questo approccio multi-vendor solleva una strozzatura operativa di rilievo: la frammentazione delle metriche di spesa. OpenAI addebita per token di prompt e completamento, AWS quantifica i costi in gigabyte e millisecondi di calcolo, mentre Twilio fattura in secondi di connessione. Tentare di eseguire un Cost Monitoring in tempo reale su queste unità eterogenee tramite i vecchi metodi di aggregazione produce report tardivi e sforamenti certi di budget.
Il Caos di Fatturazione Multi-Vendor
I modelli SaaS pre-AI potevano tollerare una riconciliazione contabile ogni 24 ore. Nell'era dei workflow autonomi su n8n che processano migliaia di chiamate LLM al minuto, un ritardo di 24 ore può tramutarsi in migliaia di dollari di addebiti API imprevisti. Se un nodo Claude 3.5 Sonnet entra in loop infinito a causa di un JSON malformato, non puoi attendere il report del giorno dopo di AWS Cost Explorer: ti serve una visibilità inferiore al secondo. Il nodo da sciogliere risiede nel convertire i Webhook di consumo grezzi — ciascuno recante formati e logiche tariffarie differenti — in un indicatore comune e immediatamente azionabile.
Standardizzare i Webhook in Micro-Cents
A tale scopo, ho ingegnerizzato un microservizio di middleware preposto a intercettare tutti i Webhook di consumo e i flussi di polling. Piuttosto che memorizzare token grezzi o secondi di calcolo, questo servizio opera come una stanza di compensazione istantanea. Analizza il payload ricevuto, identifica fornitore e scaglione del modello e applica un algoritmo di conversione dinamico per trasporre il consumo in una metrica unificata: i Micro-Cents. Applicando questa normalizzazione unificata dei dati fin dalla fase di ingestione, spogliamo i dati da ogni specificità dei singoli vendor prima del salvataggio a database.
| Provider / Servizio | Metrica di Fatturazione Grezza | Logica di Normalizzazione (Micro-Cents) |
|---|---|---|
| OpenAI (GPT-4o) | Token (Prompt/Completion) | (Tokens * Rate) * 10000 |
| AWS (Lambda/S3) | GB-Secondi / Richieste | (ComputeMs * MemRate) * 10000 |
| Twilio (Voice) | Secondi di Connessione | (Seconds * VoiceRate) * 10000 |
Archiviazione Centralizzata e Limiti di Spesa Real-Time
Una volta convertiti, questi Micro-Cents vengono aggregati e salvati in forma centralizzata per ciascun tenant ID all'interno di una cache Redis ad alte prestazioni. Si forma così un'indiscutibile fonte di verità per tutta l'infrastruttura. Poiché ogni transazione API viene immediatamente quantificata in un'unità monetaria universale, i nostri workflow di notifica su n8n possono verificare le soglie di spesa con precisione millimetrica. Abbiamo contratto la latenza di applicazione dei limiti a <150ms, permettendo al sistema di revocare le chiavi API durante l'esecuzione qualora un tenant varchi il budget assegnato. Questo severo protocollo di normalizzazione ha cancellato le oscillazioni impreviste, incrementando il ROI dell'efficienza di costo di oltre il 40%.
Instradare gli avvisi critici attraverso canali headless
La posta elettronica è il cimitero delle notifiche tecniche di emergenza. Nel momento in cui un provider LLM o un'API esterna inizia a bruciare liquidità a un ritmo di $50 al minuto per via di un loop ricorsivo, aspettare che un server SMTP recapiti un messaggio in una casella di posta affollata è pura negligenza architetturale. Un efficace Cost Monitoring pretende una comunicazione sincrona e capace di interrompere il flusso operativo. Se i tuoi allarmi FinOps di Livello 1 stazionano accanto alle newsletter promozionali, la tua capacità di reazione è già compromessa.
Architettare la Pipeline di Allarme Headless
Per cancellare i tempi morti umani, bypassiamo le dashboard tradizionali e indirizziamo le notifiche critiche direttamente nel cuore operativo del team: un canale Slack dedicato o un bot Telegram riservato. Avvalendoci di n8n, costruiamo una pipeline pilotata da Webhook che coglie l'anomalia e inoltra un avviso ad alta priorità in meno di 200ms. Non si tratta unicamente di garantire visibilità; si tratta di predisporre un'integrazione headless con bot Telegram che agisce come vero e proprio centro di comando per l'infrastruttura.
Con i canoni del 2026, confidare nell'aggiornamento manuale delle schermate è anacronistico. Il workflow n8n riceve il Webhook emesso dall'API gateway, elabora i dettagli dell'anomalia e lancia all'istante una richiesta HTTP POST all'API del bot Telegram o alla Webhook URL di Slack. L'intera squadra ingegneristica viene così avvisata nell'esatto millisecondo in cui si consuma la violazione della soglia.
Strutturare il Payload di Allarme Deterministico
Un avviso critico perde ogni utilità se impone a un tecnico di accedere a una console AWS o Datadog per comprendere la portata dell'evento. Il messaggio recapitato sui canali headless deve risultare categoricamente deterministico. Configuriamo il nodo HTTP Request in n8n per formattare il payload JSON con parametri operativi puntuali, azzerando ogni ambiguità durante la gestione dell'incidente.
I dati imprescindibili devono riportare:
- Tenant ID: L'utente o l'organizzazione responsabile del consumo anomalo.
- Velocità di Spesa: Il tasso esatto di spesa calcolato in tempo reale (es. $45,50/minuto).
- Endpoint Responsabile: La rotta API precisa che ha generato il picco.
- Stato del Circuit Breaker: Una conferma booleana che attesti l'avvenuto intervento del kill switch per arginare l'emorragia finanziaria.
Ecco l'esatto schema JSON da associare al nodo n8n per Slack o Telegram:
{
  "alert_level": "TIER_1_CRITICAL",
  "tenant_id": "org_98765_alpha",
  "spend_velocity_per_min": 45.50,
  "faulty_endpoint": "api.openai.com/v1/chat/completions",
  "circuit_breaker_fired": true,
  "timestamp": "2026-10-14T08:12:45Z"
}
Quando un tecnico riceve questo messaggio, l'onere cognitivo è nullo. Comprende immediatamente chi ha originato l'anomalia, quale sia stata la spesa, dove si sia verificata e — elemento decisivo — che l'infrastruttura si è già auto-riparata facendo scattare il circuit breaker. Questo routing deterministico è la pietra angolare della resilienza moderna dei sistemi.
Quantificare l'impatto sull'MRR dei controlli deterministici dei costi
Nel panorama della growth engineering del 2026, accontentarsi di rendiconti contabili di fine giornata è una vulnerabilità catastrofica. Per difendere realmente il tuo Monthly Recurring Revenue (MRR), devi compiere il salto dal Cost Monitoring passivo all'ingegneria finanziaria deterministica. Per CTO e founder tecnici, ciò implica allestire un'infrastruttura capace di proteggere attivamente la unit economics all'estremo perimetro di rete.
Azzerare il Premio di Rischio per Abuso delle API
Gran parte delle realtà SaaS native per l'AI include inconsapevolmente nel proprio listino un "premio di rischio per abuso API": un cuscinetto economico implicito destinato ad assorbire le spese inevitabili dovute ad allucinazioni degli LLM, prompt ricorsivi o scraping aggressivo. Integrando circuit breaker zero-touch, questo ricarico viene cancellato. Nel momento in cui l'infrastruttura è in grado di tranciare le connessioni anomale in una manciata di millisecondi, ottieni un'espansione istantanea dei margini lordi senza dover rimettere mano al listino base del prodotto.
Non stiamo parlando di predisporre alert su Slack che un ingegnere potrebbe visualizzare dopo ore: si tratta di attivare kill switch algoritmici che intervengono senza alcuna mediazione umana.
Caso Studio: Disinnescare un'Anomalia da $14.000
Si consideri una recente implementazione per una piattaforma mid-market di workflow automation guidata da AI. Un utente ha involontariamente azionato un loop ricorsivo di prompt injection che ha generato migliaia di chiamate API simultanee verso OpenAI. Con un monitoraggio tradizionale a cadenza di 24 ore, questo picco avrebbe prodotto circa $14.000 di addebiti in token prima della sincronizzazione contabile del giorno dopo.
L'infrastruttura FinOps si avvaleva invece di un circuit breaker all'Edge orchestrato tramite n8n. Il sistema ha confrontato il ritmo di consumo dei token con una baseline dinamica. La sequenza dei fatti si è svolta con precisione:
- Minuto 1: Il traffico balza al 400% oltre la media mobile a 7 giorni. Il sistema rileva l'anomalia ma consente il transito per evitare falsi positivi.
- Minuto 2: Il loop ricorsivo accelera, infrangendo il tetto rigido di
$10.00/minutoper singolo tenant. - Minuto 3: Il workflow n8n inoltra un Webhook all'API gateway, applicando una regola
429 Too Many Requestsmirata esclusivamente all'identificativo del tenant responsabile.
L'escalation dei costi è stata fermata a esattamente $42. Avendo sventato una perdita di $14.000 in un singolo frangente, il circuit breaker zero-touch ha ripagato all'istante l'intero investimento nell'infrastruttura FinOps.
Architettare Controlli Zero-Touch con n8n
Per edificare questo strato di controllo deterministico, devi disaccoppiare la logica dell'applicazione dai presidi finanziari di sicurezza. Tramite n8n puoi organizzare routine di polling ad alta frequenza che interrogano direttamente la cache Redis dell'API gateway.
All'individuazione di uno sforamento della soglia, il flusso trasmette un payload JSON snello — come {"action":"block","tenantId":"usr_9876","duration":"1h"} — al tuo router di frontiera. In questo modo il raggio dell'impatto finanziario viene confinato al singolo utente, garantendo che il resto della clientela non subisca alcuna alterazione di latenza o fermi di servizio mentre la minaccia viene neutralizzata.
Audit della vulnerabilità attuale ai picchi di utilizzo
Numerosi responsabili tecnici coltivano una pericolosa illusione in merito alla propria infrastruttura di Cost Monitoring. Riporre fiducia in AWS Budgets o negli avvisi di fatturazione di GCP è un retaggio rischioso. Nel momento in cui una notifica aggregata giunge al tuo canale Slack, uno script errato o un intruso ha già eroso la liquidità mensile della tua azienda. Per far emergere questo punto cieco, devi condurre un test diagnostico empirico e inflessibile sulla tua infrastruttura oggi stesso.
Lo Stress Test in Ambiente di Staging
Smetti di fare supposizioni teoriche sulle tue difese e simula un evento critico. Questo test misura l'intervallo esatto in secondi tra un massiccio carico simultaneo di chiamate API e il primo segnale di allarme automatizzato della tua infrastruttura.
- Passo 1: Isolare un Endpoint ad Alto Costo. Seleziona un endpoint di staging che replichi le tue operazioni di produzione più onerose, come un wrapper di inferenza LLM o un'interrogazione pesante a un database vettoriale.
- Passo 2: Scatenare un Carico Concorrente. Implementa un tool di load-testing come k6 o Artillery. Configura lo script per inondare l'endpoint con 1.000 richieste al secondo (RPS), simulando un attacco di tipo Denial-of-Wallet (DDoW).
- Passo 3: Avviare il Cronometro. Monitora il tuo attuale stack di notifica. Registra il tempo esatto necessario affinché il sistema allerti il team tecnico. Non arrestare il cronometro fino alla comparsa di un messaggio chiaro e leggibile da un operatore umano.
Calcolare il Raggio di Rischio Finanziario
I risultati di questa verifica sono solitamente impietosi. I sistemi di fatturazione cloud convenzionali operano spesso su cicli di aggregazione tra le 12 e le 24 ore. Se il tuo Time-to-Alert (TTA) si attesta a 14 ore, operi con una finestra temporale di vulnerabilità insostenibile. Devi calcolare l'esatto costo finanziario di tale ritardo.
Se il tuo endpoint costa $0,01 per esecuzione e l'ondata sostiene 1.000 RPS, stai disperdendo $10 al secondo. Un ritardo di notifica di 14 ore corrisponde a un'esposizione economica di $504.000. È la ragione per cui l'onere finanziario medio delle violazioni API cloud non deriva unicamente dall'esfiltrazione tradizionale dei dati, ma dal dissanguamento computazionale ed economico. Affidarsi unicamente a standard piattaforme enterprise di protezione API senza circuit breaker finanziari in tempo reale apre una voragine operativa spaventosa.
Automazione 2026 vs Polling Tradizionale
Per sopravvivere alle derive dei consumi API, devi abbandonare il monitoraggio dei costi elaborato in batch e abbracciare un'architettura interamente event-driven.
| Metrica | Avvisi di Fatturazione Cloud Legacy | Automazione Event-Driven 2026 |
|---|---|---|
| Latenza di Notifica (TTA) | 43.200 - 86.400 secondi | < 0.2 secondi |
| Esposizione Finanziaria (a $10/sec) | $432.000+ | $2.00 |
| Meccanismo di Mitigazione | Intervento Manuale DevOps | Webhook n8n con Kill-Switch su API Gateway |
Inoltrando gli eventi di rate-limit da Redis direttamente a un Webhook n8n, bypassi completamente i ritardi di rendicontazione dei fornitori cloud. L'automazione analizza il payload, controlla il livello dell'utente e trasmette immediatamente un avviso su Slack, azionando simultaneamente una chiamata POST all'API gateway per limitare l'IP responsabile. È questo il divario che separa una minima anomalia operativa da una fattura capace di decretare la chiusura di un'azienda.
Il consumo incontrollato delle API è una minaccia mortale per la scalabilità del SaaS moderno. Sostituendo le dashboard passive con circuit breaker automatizzati all'Edge, proteggi deterministicamente i tuoi margini ed elimini il rischio di costi infrastrutturali impazziti. Il mercato del 2026 esige sistemi capaci di auto-ripararsi e autoregolarsi senza la supervisione umana. Se la tua architettura fa ancora affidamento su avvisi di fatturazione differiti, stai operando a tempo prestato. Smetti di disperdere fatturato e prenota un audit tecnico approfondito per blindare la tua infrastruttura.
Memo Strategici Correlati
Tutti i Memo →Architecting an AI lead qualifier: Zero-touch B2B conversion pipelines for 2026
Static forms are dead capital. In 2026, forcing a high-intent enterprise prospect to wait 24 hours for SDR triage guarantees lead decay and negative CAC yiel...
Database sharding strategy: Partitioning high-growth SaaS tables across nodes
Monolithic relational databases inevitably break under asymmetric SaaS scale. Once your core transactional tables cross 500 million rows, standard vertical s...
Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.