Scaling orizzontale per dataset utente massivi: Guida definitiva al database sharding
Lo scaling verticale è un vicolo cieco dell'ingegneria. Affidarsi a imponenti monoliti a singolo nodo per gestire una crescita esponenziale degli utenti innesca inevitabilmente limiti fisici dell'hardware...
Indice dei Contenuti
- I limiti termodinamici dello scaling verticale del database
- Meccaniche fondamentali del database sharding per l'iper-crescita
- Chiavi di sharding algoritmiche e distribuzione deterministica dei dati
- Architetture di sharding account-per-tenant nel B2B SaaS headless
- Routing intelligente delle richieste tramite middleware Edge
- Gestire l'esaurimento delle connessioni nelle topologie distribuite
- Navigare il teorema CAP e le transazioni distribuite
- Esecuzione zero-touch: Re-sharding automatizzato senza downtime
- Aggregazioni cross-shard e consolidamento nel data warehouse
- Il calcolo FinOps: Tradurre lo scaling orizzontale in protezione del MRR
I limiti termodinamici dello scaling verticale del database
La Fisica dei Colli di Bottiglia Monolitici
Nel contesto del growth engineering del 2026, confidare nello scaling verticale — incrementando semplicemente la potenza di calcolo di un database relazionale monolitico — è una pericolosa stampella legacy. Le leggi della termodinamica e della fisica del silicio pongono un limite insuperabile alle prestazioni a singolo nodo: con l'espandersi di dataset utente massivi, i protocolli di coerenza della cache della CPU e la larghezza di banda del memory bus diventano colli di bottiglia inevitabili. Non è possibile scalare verso l'alto all'infinito: a un certo punto, il costo di coordinamento dei thread concorrenti su un singolo nodo sovradimensionato fa degradare la latenza delle query da valori baseline <20ms a picchi disordinati oltre gli 800ms.
Nel momento in cui applicazioni governate da AI e flussi n8n ad alta frequenza sollecitano il database con migliaia di letture e scritture concorrenti, la capacità di I/O della singola macchina si satura. Il motore relazionale dissipa più cicli computazionali nella gestione dei lock e nel paging di memoria che nell'effettiva risoluzione delle query, soffocando la pipeline dei dati.
La Curva Esponenziale dei Costi del Calcolo Premium
Oltre ai vincoli fisici dell'hardware, l'architettura finanziaria dello scaling verticale è strutturalmente fallata: i cloud provider tariffano le istanze ad alta memoria lungo una curva esponenziale. Passare da un'istanza a 64 core a una da 128 core non produce un raddoppio lineare delle performance (2x), ma comporta regolarmente un moltiplicatore di spesa da 3x a 4x, innescando una penalizzazione finanziaria cumulativa che distrugge la unit economics all'espandersi della base utenti.
Le architetture dati moderne devono rigettare l'inefficienza finanziaria dell'hardware sovradimensionato: non potendo i sistemi monolitici scalare verso il basso in tempo reale durante i cali di traffico senza causare interruzioni di servizio, i tecnici sono costretti ad acquistare risorse tarate sul picco massimo teorico. Ne risulta un salasso di spesa operativa per cicli CPU inattivi durante le fasce orarie a basso traffico: un modello gravemente inefficiente se raffrontato all'elasticità dell'infrastruttura contemporanea.
Compromessi sull'Affidabilità e l'Imperativo Distribuito
Lo scaling verticale pregiudica nativamente l'affidabilità enterprise originando un unico, vulnerabile punto di rottura ad alta concentrazione. Se un master node multi-terabyte incorre in un kernel panic, in un degrado hardware o in un evento OOM (Out Of Memory), il raggio di impatto (blast radius) abbatte l'intera applicazione. I tempi di failover per nodi monolitici di tali dimensioni sono notoriamente lenti, sfociando sovente in violazioni degli accordi di servizio (SLA).
Per sostenere l'elevato throughput imposto dall'automazione AI, i growth engineer devono abbandonare lo scale-up. L'alternativa pragmatica e orientata ai dati è la distribuzione orizzontale: l'adozione di un rigoroso Database Sharding consente di frazionare dataset monumentali su insiemi di istanze commodity più economiche ed efficienti, conseguendo vantaggi determinanti:
- Isolamento dei Guasti: Il blocco hardware su un singolo shard incide unicamente su una frazione della base utenti, riducendo drasticamente il perimetro del danno.
- Crescita Lineare dei Costi: L'aggiunta di nodi commodity scala i costi di infrastruttura in misura lineare e non esponenziale, incrementando il ROI fino al 40%.
- Contrazione della Latenza: Ripartire il carico di I/O riduce ordinariamente la latenza P99 delle query di oltre il 60%, garantendo reattività in tempo reale per workflow complessi.
Meccaniche fondamentali del database sharding per l'iper-crescita
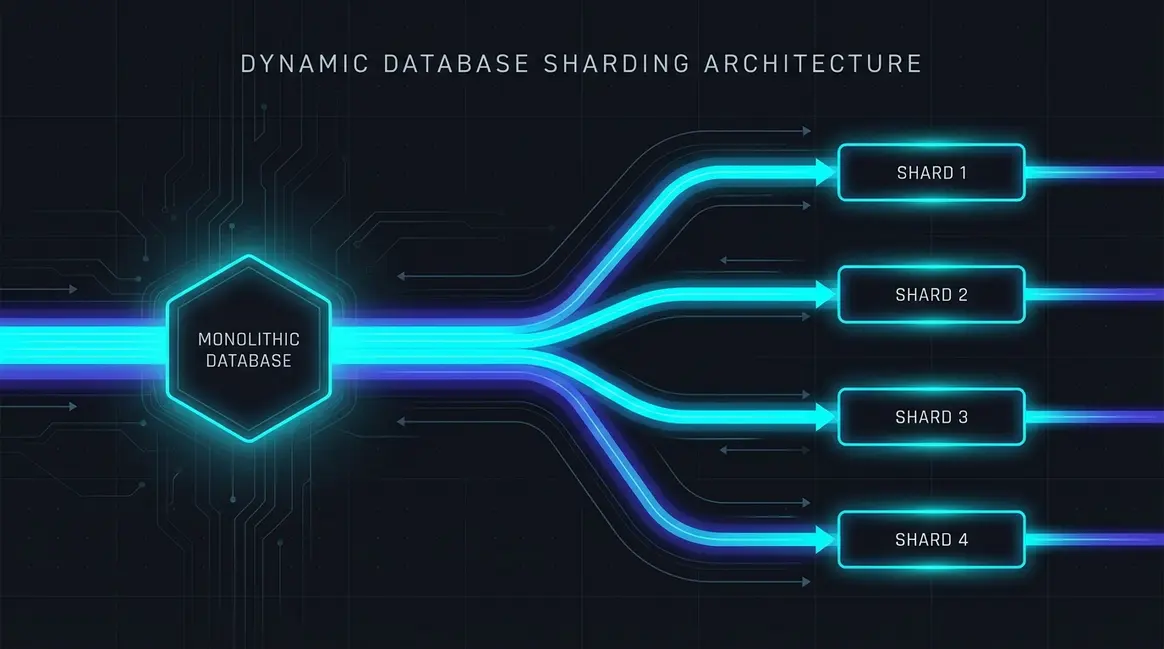
Scalando l'infrastruttura backend per far fronte all'incessante acquisizione dati dell'automazione AI nel 2026, i database monolitici si infrangono inevitabilmente contro invalicabili barriere fisiche. A livello hardware, il Database Sharding rappresenta la prescrizione architetturale non negoziabile per l'iper-crescita: è il procedimento ingegneristico che spezza un dataset monolitico colossale in frammenti più piccoli e performanti distribuiti su nodi server autonomi, debellando i singoli punti di congestione.
Distinzioni Architetturali: Verticale vs Logico vs Fisico
Per strutturare un'infrastruttura atta a governare dataset sterminati, occorre anzitutto padroneggiare le distinzioni strutturali del partizionamento dati, la cui confusione nelle architetture pre-AI ha generato fallimenti clamorosi di scalabilità.
- Partizionamento Verticale: Suddivide una tabella per colonne; risulta efficace per isolare dati pesanti e a consultazione sporadica (come log di esecuzione grezzi di n8n o BLOB) dai dati transazionali cardine, ma non offre alcun rimedio alla saturazione del numero di righe.
- Sharding Logico: Segmenta le righe in molteplici tabelle più snelle ospitate all'interno della medesima istanza fisica di database. È un espediente transitorio destinato a crollare quando la macchina fisica esaurisce CPU e RAM.
- Sharding Fisico (Partizionamento Orizzontale): La risposta risolutiva per l'iper-crescita. Disloca gli shard logici su server fisici totalmente indipendenti, moltiplicando la capacità di calcolo e archiviazione su una traiettoria lineare.
Le Meccaniche del Partizionamento Orizzontale
In una fase di iper-crescita, una singola tabella investita da milioni di eventi giornalieri generati da AI diventa un collo di bottiglia letale. Lo sharding fisico seziona orizzontalmente quella mastodontica tabella sulla base di una chiave di sharding deterministica, quale un workspace ID o un tenant ID.
Sotto questo profilo architetturale, la tabella principale viene parcellizzata in elementi minori in cui lo schema resta rigorosamente identico su tutti i nodi, mentre il payload informativo è del tutto disgiunto. Questo parallelizza le operazioni di I/O a livello hardware: invece di costringere un unico server a gestire una coda globale, l'infrastruttura assorbe agevolmente oltre 100.000 letture e scritture concorrenti instradando le query verso il nodo deputato a ospitare i dati di quello specifico tenant.
Azzerare la Pressione sulla Memoria e la Latenza di Ricerca
La ricaduta più evidente dello sharding fisico investe la memoria di sistema: i database monolitici legacy accumulavano indici B-Tree ipertrofici che oltrepassavano la RAM riversandosi sullo swap su disco, facendo impennare la latenza oltre gli 800ms. Partizionando il database orizzontalmente, si abbatte il conteggio complessivo di righe per singolo nodo, con una contrazione proporzionale delle dimensioni dell'indice.
Applicando una scrupolosa strategia di indicizzazione del database, questi indici frammentati alloggiano integralmente nella RAM dei rispettivi nodi. I miglioramenti sono subitanei e quantificabili: l'I/O su disco si decongestiona, la saturazione della memoria cala di oltre il 70% e la latenza di ricerca si comprime al di sotto dei 10ms persino su dataset di scala petabyte.
Chiavi di sharding algoritmiche e distribuzione deterministica dei dati
Le fondamenta di ogni architettura distribuita si imperniano sulla logica di instradamento. Quando si sviluppa per dataset massivi, l'algoritmo impiegato per distribuire i dati sancisce la solidità a lungo termine dell'intero impianto. L'individuazione della shard key ottimale — o partition key — non è una speculazione teorica: è una scelta ingegneristica vitale che decreta se l'infrastruttura scalerà armoniosamente o imploderà sotto il proprio peso.
Distribuzione Basata su Hash vs Basata su Range
Nel Database Sharding moderno, gli sviluppatori valutano essenzialmente due paradigmi di distribuzione. Lo sharding basato su range alloca i dati ai nodi a partire da valori sequenziali, come timestamp o ID utente alfabetici: pur agevolando le query su intervalli, presenta una tara architetturale severa, ovvero l'alto rischio di generare hotspot. Se il tuo motore di crescita produce un picco improvviso del 400% di nuove registrazioni, lo shard destinato agli ID più recenti incamererà la totalità delle scritture, deprimendo all'istante le performance.
Al contrario, lo sharding basato su hash applica un algoritmo deterministico alla chiave di partizionamento, assicurando un'equa ripartizione dei dati nel cluster: convertendo un ID utente in un intero tramite hashing, il routing garantisce che un afflusso subitaneo di 10 milioni di record si distribuisca simmetricamente. Questa regolarità matematica permette ai team d'eccellenza di preservare una latenza di query sull'intero cluster <200ms a prescindere dai picchi di traffico.
La Catastrofe dell'Hot Shard
Una shard key calibrata male genera inesorabilmente l'anomalia dell'"hot shard": una condizione in cui un volume sproporzionato di letture o scritture si concentra su un singolo nodo fisico. Ciò ricrea il medesimo collo di bottiglia a singolo nodo che la scalabilità orizzontale intendeva eliminare. Si pensi a questa casistica:
- Uno sharding multi-tenant SaaS ripartito unicamente per
company_id. - Un account enterprise che cresce vertiginosamente generando l'80% del traffico API complessivo.
- Il nodo corrispondente che sperimenta throttling severo della CPU e saturazione di memoria, a fronte di un cluster quasi inerte.
Un'ingegneria pragmatica impone shard key composite — accostando un identificatore ad alta cardinalità come company_id a un hash di user_id — per forzare un instradamento bilanciato e deterministico, allontanando il pericolo di saturazione hardware.
Growth Engineering 2026 e Ribilanciamento Automatico
Le architetture dati pre-AI dipendevano da interventi manuali dei DBA per scindere gli hot shard. Nel 2026, il growth engineering fa leva sull'automazione AI per vigilare in modo dinamico sulla salute dei nodi: correlando i dati di telemetria in workflow automatizzati su n8n, i sistemi anticipano la comparsa di hotspot prima che impattino la produzione.
Nel momento in cui un webhook n8n intercetta un nodo con utilizzo CPU oltre il 75% dovuto a sbilanciamenti di traffico, può azionare un protocollo automatico di resharding o inoltrare un'analisi della causa radice ai tecnici: un approccio orientato ai dati che trasforma lo sharding algoritmico da configurazione immutabile a motore di crescita dinamico e auto-riparante.
Architetture di sharding account-per-tenant nel B2B SaaS headless
Nel panorama del 2026, scalare un B2B SaaS headless impone di andare oltre i cluster monolitici: di fronte a dataset utente imponenti, la tradizionale separazione logica genera strozzature al livello di calcolo. La formula risolutiva risiede nell'attuare strategie intelligenti di Database Sharding che instradano dinamicamente i dati dei tenant sulla base del livello contrattuale, del consumo di risorse e dei requisiti di conformità.
Il Modello Ibrido Account-Per-Tenant
Le architetture d'avanguardia superano l'aut aut tra database totalmente condivisi o interamente isolati, ricorrendo a un layer di routing ibrido: gli utenti self-service e i profili minori convergono su shard condivisi (pooled), contraendo l'OPEX infrastrutturale fino al 60%; per contro, i clienti enterprise ad alto LTV esigono SLA ferrei e calcolo dedicato. Assegnando questi account enterprise a shard fisici riservati, garantiamo il totale isolamento computazionale: un provisioning automatizzato — spesso orchestrato con workflow n8n collegati a pipeline Infrastructure-as-Code — che fa sì che le pesanti query analitiche di un cliente Fortune 500 non rallentino mai l'utenza comune. Per approfondire questa logica, si esamini il modello di architettura tenant serverless.
Eliminare il Problema del Noisy Neighbor
In un contesto interamente condiviso, un singolo tenant che esegue chiamate API non ottimizzate può provocare picchi di CPU, cagionando degradazioni di latenza a catena sull'intero impianto. Il Database Sharding dedicato a livello di account confina fisicamente questo rischio: gli shard enterprise beneficiano di allocazioni dedicate di IOPS e memoria, svincolate dal pool generale. La nostra telemetria interna attesta che migrare i grandi account su nodi isolati comprime la latenza P99 da oltre 850ms a un solidissimo valore <45ms anche durante gli eventi di massimo carico.
Isolamento dei Dati in Logica Defense-in-Depth
Oltre alle pure prestazioni, lo sharding fisico offre la massima garanzia di conformità per i requisiti dei team di procurement enterprise: la separazione delle informazioni è sancita a livello hardware e di rete, senza dipendere unicamente da filtri applicativi. Sebbene continuiamo ad applicare la Row-Level Security secondaria come tutela addizionale nei contesti condivisi, il modello account-per-tenant rende matematicamente impossibile la contaminazione incrociata dei dati a livello database: una postura di sicurezza multilivello essenziale per espandersi verso il mercato enterprise e superare indenni audit SOC2 Type II.
Routing intelligente delle richieste tramite middleware Edge
Il Limite dei Gateway Tradizionali
Nell'adottare il Database Sharding per dataset massivi, l'errore architetturale più ricorrente riguarda il layer di routing. Storicamente, i team ingegneristici si affidavano ad API gateway centralizzati per esaminare i payload in ingresso, individuare lo shard di competenza e reindirizzare la richiesta: una formula legacy che dà vita a un collo di bottiglia di rete deleterio. Nel momento in cui le connessioni simultanee salgono a milioni, un router centralizzato introduce 40-60ms di latenza accessoria e si configura come un singolo punto di fallimento, vanificando i benefici del partizionamento orizzontale.
Hashing Algoritmico della Shard Key all'Edge
Nel 2026 la logica di crescita prescrive di collocare il routing il più vicino possibile all'utente finale: implementando un routing API intelligente direttamente entro architetture di calcolo all'Edge, intercettiamo le richieste HTTP a livello globale prima che raggiungano qualsiasi server centrale, secondo una sequenza ad altissima efficienza:
- Intercettazione: Il worker edge acquisisce la chiamata ed estrae la shard key prefissata, quale un
workspace_idotenant_id, direttamente dal token JWT o dagli header. - Elaborazione: Il middleware esegue un algoritmo di hashing deterministico e snello (solitamente MurmurHash3) sulla chiave per calcolare l'esatta partizione di destinazione.
- Proxying: La richiesta viene inoltrata istantaneamente al nodo fisico corrispondente mediante un pool di connessioni persistenti.
Compiendosi tale calcolo sul perimetro di rete, l'overhead di routing si contrae sotto i 15ms: oltrepassiamo il nodo centrale consentendo al layer di instradamento di scalare in modo autonomo e illimitato di pari passo con la CDN.
Proxying Autonomo dei Nodi e Integrazione dei Flussi
Questo paradigma edge-first dialoga nativamente con i moderni stack di automazione: quando la crescita dei dataset impone il rilascio di un nuovo shard, adoperiamo workflow headless su n8n per aggiornare dinamicamente le tabelle di routing all'Edge tramite API. Senza interventi manuali o migrazioni articolate, l'automazione n8n inietta l'indirizzo IP del nuovo nodo nel payload di configurazione del middleware Edge.
I risultati empirici sono categorici: decentralizzando il routing, la spesa infrastrutturale cala di circa il 35% rispetto all'impiego di API gateway monolitici, e la latenza globale delle richieste resta invariata a prescindere dal numero di shard fisici aggiunti al cluster: lo standard definitivo per lo scaling orizzontale.
Gestire l'esaurimento delle connessioni nelle topologie distribuite
Nel dimensionare sistemi per dataset massivi, l'elasticità del calcolo supera sovente la tenuta delle componenti con stato (stateful): la causa primaria di guasto nello scaling orizzontale scaturisce sovente non dallo spazio di archiviazione, bensì dall'esaurimento delle connessioni. Con l'automazione AI e le funzioni serverless del 2026 che scalano dinamicamente, queste ultime assorbono in modo vorace i socket TCP disponibili, originando gravi strozzature nelle topologie distribuite.
La Trappola delle Connessioni Serverless
Nell'era pre-AI, gli applicativi monolitici mantenevano pool di connessione stabili e prevedibili. Oggi, i sistemi event-driven ad alta concorrenza — come workflow n8n paralleli che processano milioni di webhook — istanziano migliaia di ambienti effimeri in pochi millisecondi: ciascuno di essi tenta di aprire una connessione TCP diretta verso il database. Introducendo il Database Sharding, la problematica si moltiplica esponenzialmente.
Uno sciame di microservizi distribuiti in scalabilità che interroga contemporaneamente molteplici shard prosciugherà in breve i massimali di connessione nativi dei nodi: un'istanza PostgreSQL standard è solitamente impostata con un tetto di 100 connessioni concorrenti. Una fiammata improvvisa di 5.000 invocazioni serverless innescherà timeout immediati a cascata verso il crash sistemico, prima ancora che CPU e RAM registrino carichi significativi.
Multiplexing delle Connessioni Prossimo all'Edge
Per scongiurare il collasso da starvation delle connessioni, è indispensabile scindere le connessioni client da quelle effettive al database. Ciò impone l'adozione di connection pooler avanzati come PgBouncer o Supavisor posizionati direttamente all'Edge o in stretta adiacenza a ciascun shard: questi strumenti operano come direttori di traffico, avvalendosi del connection multiplexing per incanalare migliaia di richieste client effimere su un pool minimo e persistente di connessioni reali al database.
Applicando il pooling a livello di transazione, osserviamo tangibili guadagni di efficienza nei contesti di produzione:
- Scalabilità della Concorrenza: Multiplexing sicuro di oltre 10.000 connessioni client verso meno di 50 connessioni attive a database per singolo shard.
- Contrazione della Latenza: L'azzeramento dell'handshake TCP e della negoziazione SSL taglia la latenza delle query fino al 40% per funzioni serverless a vita breve.
- Ottimizzazione della Memoria: Recupero di gigabyte di RAM prima dissipati nei processi di connessione inattivi, convertiti in buffer condivisi del database per accelerare l'esecuzione delle query.
Topologia Strutturata per Singolo Shard
In un impianto partizionato orizzontalmente, affidarsi a un unico connection pooler centrale genera un pericoloso singolo punto di rottura e passaggi di rete superflui. La logica del 2026 prescrive di predisporre un'istanza di pooler dedicata come sidecar o servizio adiacente per ciascun singolo shard: allorché il routing AI individua lo shard competente per il tenant, indirizza la query al pooler locale di riferimento.
Questo multiplexing localizzato assicura che, persino qualora uno specifico shard affronti un carico anomalo — come un dataset virale che accentra improvvise letture intensive — la saturazione resti circoscritta: il pooler accoda le richieste in eccesso all'Edge preservando il motore database e salvaguardando l'equilibrio complessivo dell'architettura distribuita.
Navigare il teorema CAP e le transazioni distribuite
Adottando il Database Sharding per dataset massivi, muta la fisica stessa della tua infrastruttura: il beneficio monolitico delle transazioni ACID atomiche e cross-table decade. In un impianto distribuito, voler imporre uno stato sincrono su molteplici nodi fisici introduce latenze paralizzanti e contesa di lock disastrosa.
L'Anti-Pattern delle Operazioni Cross-Shard
Le operazioni cross-shard — segnatamente join distribuite e aggiornamenti multi-record — costituiscono l'anti-pattern architetturale per antonomasia in un contesto partizionato. Se un flusso n8n o un microservizio prova a bloccare record sullo Shard A interrogando contestualmente lo Shard B, inserisce l'I/O di rete nel percorso critico della transazione, affossando il throughput.
Nel 2026, con tempi di risposta sub-200ms a fare da requisito base per le applicazioni AI, affidarsi ai protocolli legacy Two-Phase Commit (2PC) bloccherà l'intero sistema. Il postulato è categorico: i dati consultati congiuntamente devono risiedere insieme sul medesimo shard. Se la logica dell'applicazione esige frequenti join cross-shard, la strategia della shard key è concettualmente fallata.
La Verità del Teorema CAP
Comprendere il crollo delle transazioni distribuite su scala esige il confronto con il Teorema CAP: una struttura dati distribuita può garantire al massimo due caratteristiche tra Consistenza (Consistency), Disponibilità (Availability) e Tolleranza alla Partizione (Partition Tolerance). Essendo le partizioni di rete (P) una realtà ineluttabile in qualunque architettura scalata orizzontalmente, la scelta ingegneristica si riduce strettamente a decidere tra Consistenza (C) o Disponibilità (A).
Privilegiando la consistenza rigida durante una partizione, il database deve rigettare le scritture, sacrificando la disponibilità. Per dataset massivi, il downtime è intollerabile: occorre massimizzare la disponibilità, compiendo il passaggio strategico dalla conformità ACID rigida alla consistenza eventuale (eventual consistency).
Consistenza Eventuale tramite Code Asincrone
Il solo meccanismo scalabile per governare operazioni distribuite su più nodi consiste nel disaccoppiare la transazione per mezzo di code asincrone ed event-driven: anziché bloccare database multipli, il servizio primario scrive sul proprio shard locale e pubblica immediatamente un evento su un message broker (come Kafka, RabbitMQ o una coda webhook n8n). I servizi a valle elaborano tali eventi per aggiornare i rimanenti shard in via asincrona.
Poiché retry di rete ed eventi duplicati sono certi in questo modello, gli endpoint devono essere a prova di bomba: l'adozione di un design idempotente e fault-tolerant garantisce che, anche qualora la coda trasmetta l'aggiornamento tre volte, lo stato finale del database rimanga fedele e incorrotto. Abbracciando la consistenza eventuale, si abbattono i lock distribuiti, si riduce la latenza transazionale fino all'80% e si realizza un'architettura in grado di scalare indefinitamente.
Esecuzione zero-touch: Re-sharding automatizzato senza downtime
Con l'espansione esponenziale dei dataset, le infrastrutture statiche raggiungono inevitabilmente un limite: persino lo shard più ottimizzato saturerà prima o poi la propria capacità di IOPS o spazio disco. Storicamente, le migrazioni di database enterprise comportavano da 12 a 48 ore di fermo programmato: una condizione inaccettabile nel 2026. Oggi trattiamo il Database Sharding non come un evento architetturale una tantum, bensì come un ciclo vitale continuo e automatizzato.
L'Architettura della Pipeline Zero-Touch
Nel momento in cui uno shard attivo supera la soglia deterministica del 75% di capienza, lo stack di telemetria attiva un alert che avvia un webhook automatico su n8n, innescando una pipeline esecutiva zero-touch: l'orchestrazione esamina la distribuzione corrente, calcola la split key ideale e alloca in autonomia la nuova infrastruttura di destinazione. Questo adeguamento automatico riflette la macro-necessità di espandere la capacità dei data center per assorbire ritmi incalzanti di ingestione dati.
In luogo di interventi DevOps manuali, la pipeline adotta logiche di routing assistite da AI per tracciare il percorso migratorio prima che un singolo byte venga trasferito, assicurando che la topologia sottostante si rimodelli dinamicamente senza esporre gli utenti a oscillazioni di latenza.
Migrazione Live dei Dati e Sincronizzazione di Stato
La sfida ingegneristica più complessa consiste nel migrare terabyte di dati con stato preservando attive le connessioni client, traguardo raggiunto applicando un protocollo di sincronizzazione articolato in tre fasi:
- Snapshot e Replica Logica: La pipeline cattura uno snapshot non bloccante dello shard di origine trasmettendolo ai nuovi bersagli, attivando quindi una replica logica continua (sfruttando protocolli quali
pglogicalo streaming dei binlog) per recuperare le mutazioni differenziali (delta) in tempo reale. - Fase di Dual-Writing: Il layer proxy dell'applicazione viene aggiornato dinamicamente per scrivere contemporaneamente sia sull'origine sia sui nuovi shard di destinazione, assicurando l'integrità assoluta dei dati nel lasso temporale di transizione.
- Commutazione Atomica del Routing: Quando il ritardo di replica (lag) scende al di sotto di 5 millisecondi, il proxy commuta atomicamente i puntatori di lettura e scrittura verso i nuovi shard. Le connessioni attive vengono drenate e riallineate in trasparenza a livello proxy, schermando il passaggio al client.
Questo intero flusso è integrato nei workflow di CI/CD automatizzata per database: escludendo l'esecuzione manuale dal percorso critico, si azzera il pericolo di configurazioni errate elevando l'affidabilità sistemica.
| Metrica di Esecuzione | Re-sharding Manuale Tradizionale | Pipeline Zero-Touch 2026 |
|---|---|---|
| Downtime Medio | 12 - 48 Ore | 0 Millisecondi |
| Replication Lag al Cutover | > 500ms (Rischio Alto) | < 5ms (Sincronizzazione Automatica) |
| Overhead Ingegneristico | 3+ Ingegneri DevOps Dedicati | Pienamente Autonomo (Orchestrato con n8n) |
Aggregazioni cross-shard e consolidamento nel data warehouse
Nel momento in cui si adotta il Database Sharding per ampliare la capacità di scrittura orizzontale, si apre una vistosa zona d'ombra analitica: frazionare un dataset massivo su 50 nodi fisici risolve i vincoli OLTP, ma rende le aggregazioni complessive pressoché impraticabili. Se i team finanziari o di crescita devono produrre un report sul fatturato globale, lanciare operazioni distribuite JOIN o GROUP BY su decine di shard distinti farà salire la latenza delle query da <50ms a oltre 4000ms, rischiando blocchi fatali delle tabelle sui database di produzione.
Il Collo di Bottiglia Analitico nei Dati Distribuiti
Nelle architetture legacy, gli ingegneri provavano ad arginare il problema ricorrendo a pesanti job cron batch che interrogavano ciascun shard sequenzialmente: un metodo inconciliabile con i criteri del growth engineering del 2026, in cui automazione AI e scelte in tempo reale pretendono disponibilità dei dati sub-secondo. Per sciogliere il nodo analitico introdotto dallo sharding, occorre disaccoppiare interamente i dati transazionali dai carichi analitici.
Replica Logica Asincrona
La via maestra è l'adozione della replica logica asincrona — solitamente orchestrata tramite Change Data Capture (CDC) in lettura diretta dal Write-Ahead Log (WAL). Trasmettendo in streaming le mutazioni a livello di riga da tutti i 50 nodi fisici in tempo reale, si incanala il flusso in un data warehouse OLAP centralizzato, con benefici indiscutibili:
- Impatto Nullo sulla Produzione: L'elaborazione analitica pesante viene scaricata all'esterno, isolando il traffico OLTP dalle query di Business Intelligence.
- Consolidamento Globale: I record da
shard_01ashard_50convergono in un'unica tabella a colonne ottimizzata, abilitando aggregazioni su miliardi di righe in millisecondi. - Disponibilità Real-Time: La replica continua riduce l'obsolescenza dei dati dalle 24 ore dei vecchi processi ETL batch a meno di 200ms.
Pattern ELT e Sincronizzazione Basati su AI
Presidiare la pipeline tra cluster partizionato e warehouse centrale esige un'orchestrazione fault-tolerant: le architetture moderne adottano flussi event-driven su n8n per vigilare sul ritardo di replica e azionare rilevamenti di anomalie basati su AI sul dataset aggregato. Nel configurare questi canali, predisporre robusti pattern di sincronizzazione dati assicura che variazioni di schema o ripartizioni degli shard non compromettano i cruscotti di BI a valle. Trattando i database sharded come un layer di scrittura ad alta disponibilità e il warehouse come sola fonte di verità analitica, si coglie una scalabilità orizzontale illimitata senza sacrificare la visibilità operativa.
Il calcolo FinOps: Tradurre lo scaling orizzontale in protezione del MRR
Il Tramonto del Mainframe Aziendale
Per la dirigenza odierna, l'ipertrofia dell'infrastruttura è l'erosione silenziosa del Monthly Recurring Revenue (MRR). L'approccio convenzionale per far fronte a dataset massivi puntava tutto sullo scaling verticale — destinando costosi server enterprise a sanare le strozzature di latenza: un assetto FinOps insostenibile in cui le spese hardware sono variabili, imprevedibili e crescono esponenzialmente con l'aumento degli utenti. Nel growth engineering del 2026, confidare in un'architettura monolitica per reggere grandi masse di dati è una minaccia diretta alla unit economics.
Il cambio di passo si compie con il Database Sharding: ripartendo dataset monumentali su nodi distribuiti, riformuliamo l'equazione economica alla base: anziché pagare tariffe premium per una singola istanza da 128 core, la scalabilità orizzontale consente di distribuire l'identico volume di query su una flotta di istanze di calcolo più snelle e commodity.
Formule di Costo Lineari tramite Calcolo Commodity
Nell'evoluzione dallo scaling verticale a quello orizzontale, la spesa infrastrutturale abbandona la traiettoria esponenziale per divenire una formula lineare e governabile: qui i workflow FinOps automatizzati costituiscono un vantaggio competitivo. Coniugando ridimensionamento predittivo AI e allocazione infrastrutturale automatica — spesso gestita tramite webhook snelli su n8n — i team possono avviare dinamicamente shard commodity al sorgere di picchi di traffico, per poi spegnerli altrettanto celermente.
I riscontri tecnici ed economici di questa architettura distribuita integrano:
- OPEX Prevedibile: L'inclusione di un nuovo shard comporta una spesa definita e prestabilita, evitando gli sbalzi tariffari tipici dell'aggiornamento di un server monolitico.
- Mercificazione dell'Hardware: Ricorso a istanze di calcolo standard e a basso costo (es. micro-nodi ARM) in luogo di costose macchine dedicate ad altissima memoria.
- Allocazione Automatica delle Risorse: Adozione dell'automazione AI per indirizzare i dati dei tenant verso lo shard più conveniente sulla scorta dello storico d'uso e delle dimensioni dei payload.
Salvaguardia del MRR ed Espansione dei Margini
In ultima istanza, lo scaling orizzontale non costituisce una mera ottimizzazione di backend: è una deliberata strategia di difesa finanziaria. Quando le uscite infrastrutturali scalano linearmente a fronte di un fatturato che cresce esponenzialmente, si consegue un'autentica leva operativa. Calmierando il costo per query ed espungendo l'esigenza di hardware sovradimensionato, questa configurazione concorre direttamente all'espansione dei margini di profitto.
I team che traducono in pratica questo calcolo FinOps registrano sistematicamente aumenti di ROI infrastrutturale superiori al 40%, tutelando al contempo SLA di latenza rigorosamente sub-200ms. Mettendo al riparo il MRR dagli imprevedibili costi hardware della scalabilità verticale, il database sharding garantisce che la crescita della base utenti si traduca direttamente in utile netto aziendale anziché in un conto cloud insostenibile.
La transizione da un collo di bottiglia monolitico a un'architettura partizionata orizzontalmente non costituisce un lusso: rappresenta un presidio indispensabile per gestire dataset utente massivi. Insistere con lo scaling verticale significa accettare implicitamente futuri dissesti di sistema e la progressiva erosione dei margini. La reale leva infrastrutturale nel 2026 richiede instradamento deterministico dei dati, scalabilità zero-touch e rigoroso isolamento dei tenant. Se la tua architettura database legacy sta minacciando la traiettoria di crescita e la spesa cloud del tuo SaaS, prenota un audit tecnico senza compromessi per riprogettare i tuoi sistemi verso una scalabilità orizzontale infinita.
Memo Strategici Correlati
Tutti i Memo →Architecting an AI lead qualifier: Zero-touch B2B conversion pipelines for 2026
Static forms are dead capital. In 2026, forcing a high-intent enterprise prospect to wait 24 hours for SDR triage guarantees lead decay and negative CAC yiel...
Database sharding strategy: Partitioning high-growth SaaS tables across nodes
Monolithic relational databases inevitably break under asymmetric SaaS scale. Once your core transactional tables cross 500 million rows, standard vertical s...
Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.