Agente di Ricerca B2B Automatizzato con n8n & Memoria Notion
Il Segnale
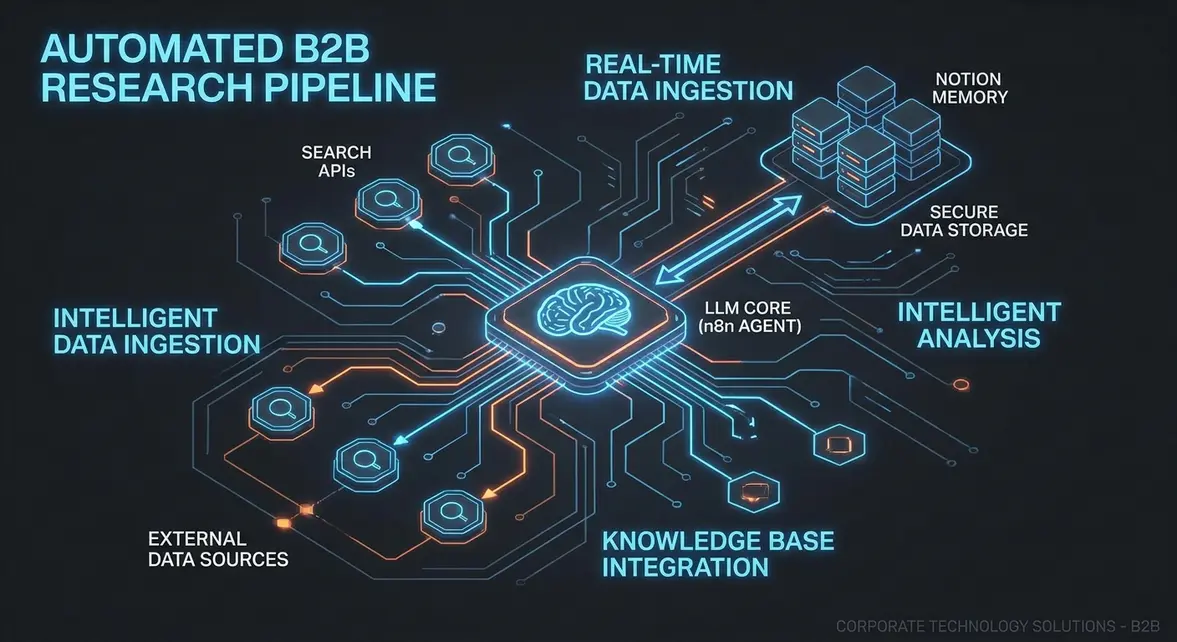
Individuare idee di business B2B sostenibili richiede spesso di farsi largo tra rumore continuo, spam e concept ridondanti. Un nuovo workflow n8n automatizza questa ricerca top-of-funnel combinando API di ricerca multi-source con memoria persistente con stato. Questo sistema agisce come un agente di ricerca autonomo, fornendo quotidianamente concept di business validati e di alta qualità.
Il Cambio di Paradigma Architetturale
Questo workflow supera il semplice scraping via API introducendo memoria con stato e routing di ricerca ad alta disponibilità. Sfruttando una finestra di contesto storico a 7 giorni, il sistema elimina alla radice l'elaborazione di dati duplicati. Questo approccio architetturale assicura un rapporto segnale/rumore eccezionalmente elevato nella ricerca automatizzata.
- High Availability: Implementa la ricerca primaria tramite Serper API con fallback automatico su Tavily API in caso di mancata risposta del provider principale.
- Memoria con Stato: Si collega a un database Notion per recuperare lo storico degli ultimi 7 giorni, fornendo il contesto all'LLM per scartare i duplicati.
- Quality Control con AI: Utilizza Claude 3 Haiku o GPT per analizzare le idee in base al potenziale di fatturato, costi di setup, livello di automazione e rischio.
- Filtraggio Intelligente: Rigetta programmaticamente truffe, MLM e modelli di servizio puramente manuali prima che raggiungano la fase di output.
Pattern di Implementazione
L'implementazione di questo agente di ricerca autonomo richiede l'orchestrazione di diversi micro-servizi distinti all'interno di n8n. Il workflow viene attivato tramite uno schedule cron giornaliero per garantire l'acquisizione costante dei dati. Di seguito è riportata la logica di esecuzione passo dopo passo:
- Trigger & Ricerca: Un cron job giornaliero avvia query su molteplici keyword sfruttando la Serper API.
- Routing di Fallback: Un nodo di branching verifica la risposta di Serper; se vuota o fallita, instrada la richiesta verso la Tavily API.
- Recupero del Contesto: Il sistema estrae lo storico delle idee degli ultimi 7 giorni da un database Notion collegato.
- Elaborazione LLM: I dati di ricerca grezzi e il contesto storico vengono inviati all'LLM con prompt rigidi per restituire JSON strutturato.
- Validazione & Archiviazione: Un nodo di codice analizza l'output JSON, aggiorna il log storico su Notion e invia le idee con il punteggio più alto su Telegram.
La Prospettiva del Fractional CTO
Per i solo founder e i team B2B lean, le ricerche di mercato top-of-funnel rappresentano un'enorme dispersione di tempo. Automatizzare questo processo con un agente intelligente e con stato sposta il capitale umano dalla raccolta passiva dei dati all'esecuzione strategica. L'OPEX necessario per eseguire questo workflow n8n è irrisorio rispetto alle ore uomo risparmiate.
Inoltre, il pattern architetturale dimostrato qui è altamente estensibile per casi d'uso enterprise. È possibile adattare questo esatto framework per il monitoraggio della concorrenza, la lead generation o la threat intelligence automatizzata. È un esempio lampante di come l'orchestrazione low-code possa dare vita ad agenti autonomi di livello enterprise.
Fonte Telemetria di Sistema: Report Ingegneristico Originale
Blueprint di Crescita Correlati
Tutti gli Esperimenti →Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.