Ingegnerizzare la dashboard real-time nel 2026: WebSocket vs. Server-Sent Events per i feed KPI live
La maggior parte delle piattaforme B2B SaaS nel 2026 sta ancora soffocando i propri database con il polling REST sincrono. Questa è negligenza ingegneristica. Una dashboard in tempo reale è...
Indice dei Contenuti
- Il declino architetturale del polling sincrono nel B2B SaaS
- Valutazione delle primitive di protocollo: WebSocket vs. Server-Sent Events (SSE)
- Perché gli SSE dominano la telemetria KPI unidirezionale nel 2026
- Esecuzione dello stato bidirezionale: quando i WebSocket sono davvero obbligatori
- Disaccoppiare il database: Middleware Edge e Logical Replication di Postgres
- Arricchimento asincrono dei payload tramite n8n prima della consegna all'Edge
- Protocolli API burnless: azzerare i costi di infrastruttura
- Rendering headless delle dashboard e idratazione dello stato in Next.js
- Multiplexing delle connessioni e idempotenza nei flussi real-time
- Misurare l'impatto sull'MRR della visibilità operativa a latenza zero
Il declino architetturale del polling sincrono nel B2B SaaS
Costruire una dashboard in tempo reale utilizzando il legacy polling REST sincrono è un anti-pattern ingegneristico che distrugge silenziosamente i margini del SaaS. In un'era in cui l'automazione AI e i workflow n8n event-driven dettano l'architettura di sistema, costringere un'applicazione client a chiedere ripetutamente a un server se uno stato sia mutato è computazionalmente primitivo.
Il fallimento matematico del polling a 5 secondi
Analizziamo la matematica nuda e cruda di questo degrado architetturale. Ipotizziamo un'applicazione B2B SaaS con 2.500 utenti contemporanei. Se il frontend interroga il backend ogni 5 secondi per aggiornare un widget KPI, il sistema genera 30.000 richieste al minuto (RPM). Ciò si traduce in 1,8 milioni di richieste all'ora che colpiscono l'API Gateway, attraversano il load balancer ed eseguono query SQL ridondanti sull'istanza di database primaria.
- Esaurimento del Connection Pool: Ogni richiesta di polling consuma un thread o uno slot del pool di connessioni, provocando gravi blocchi del database e accodamento delle transazioni durante i picchi di traffico.
- Ridondanza dei Payload: Oltre il 98% di queste richieste HTTP restituisce dati invariati, sprecando banda in header HTTP ripetitivi, validazioni JWT e handshake TLS.
- Soglie minime di latenza artificiali: L'architettura fissa la freschezza dei dati a una soglia minima di 5.000ms, del tutto inaccettabile per feed KPI live che guidano trading automatizzato, routing di inventario o motori di pricing dinamico.
Inflazione dei costi cloud e spreco di calcolo
Questo approccio a forza bruta non degrada solo le prestazioni dell'applicazione; gonfia artificialmente i costi dell'infrastruttura cloud. Ogni polling ridondante consuma cicli di CPU, allocazioni di memoria e Read Capacity Units (RCU) del database. Nello scalare questa architettura su una base utenti enterprise in crescita, il drenaggio finanziario nascosto dei cicli di calcolo inefficienti diventa una passività operativa critica. I team di ingegneria finiscono per pagare ad AWS o GCP tariffe premium semplicemente per elaborare e restituire array JSON vuoti.
Violazione dei principi di system design del 2026
Il growth engineering moderno esige architetture push-based guidate dagli eventi. Che si tratti di instradare payload complessi di Webhook attraverso workflow n8n o di trasmettere in streaming insight predittivi generati dall'AI direttamente al client, deve essere il server a dettare il flusso dei dati. Il polling sincrono viola il principio cardine del system design del 2026: il calcolo deve essere impiegato solo quando lo stato sottostante cambia effettivamente. Affidarsi al polling REST per i feed di dati in tempo reale garantisce che la tua infrastruttura collasserà esattamente nel momento in cui il prodotto raggiungerà una scala significativa, costringendoti a costosi scaling verticali di emergenza anziché a un elegante refactoring architetturale.
Valutazione delle primitive di protocollo: WebSocket vs. Server-Sent Events (SSE)
Nel progettare una dashboard in tempo reale per gli stack di growth engineering del 2026, affidarsi ciecamente al protocollo più sponsorizzato è un errore infrastrutturale critico. Dobbiamo eliminare il rumore di fondo del marketing e valutare le primitive di protocollo con uno sguardo oggettivo e pragmatico. La decisione si riduce in definitiva a un singolo vincolo architetturale: la direzionalità dei dati.
WebSockets: il costo dello stato bidirezionale
I WebSocket forniscono un canale di comunicazione persistente e full-duplex su una singola connessione TCP. Sebbene siano il gold standard per applicazioni collaborative altamente interattive e bidirezionali come canvas condivisi o esecuzione di trading ad altissima frequenza, introducono una pesante tassa infrastrutturale per la semplice ingestione di dati.
Poiché i WebSocket sono intrinsecamente stateful, rompono i tradizionali modelli di scaling stateless dell'HTTP. Se stai instradando migliaia di log di automazione AI concorrenti o esecuzioni di workflow n8n verso un client, mantenere tali connessioni persistenti richiede un bilanciamento del carico complesso. Non puoi semplicemente avviare nuove istanze Serverless; devi implementare layer di sincronizzazione dello stato, tipicamente basati su Redis Pub/Sub, per distribuire i messaggi tra nodi distribuiti. Ciò aumenta le spese operative (OPEX) e introduce punti di guasto non necessari quando tutto ciò di cui hai bisogno è un feed di dati unidirezionale.
Server-Sent Events (SSE): il vantaggio unidirezionale di HTTP/2
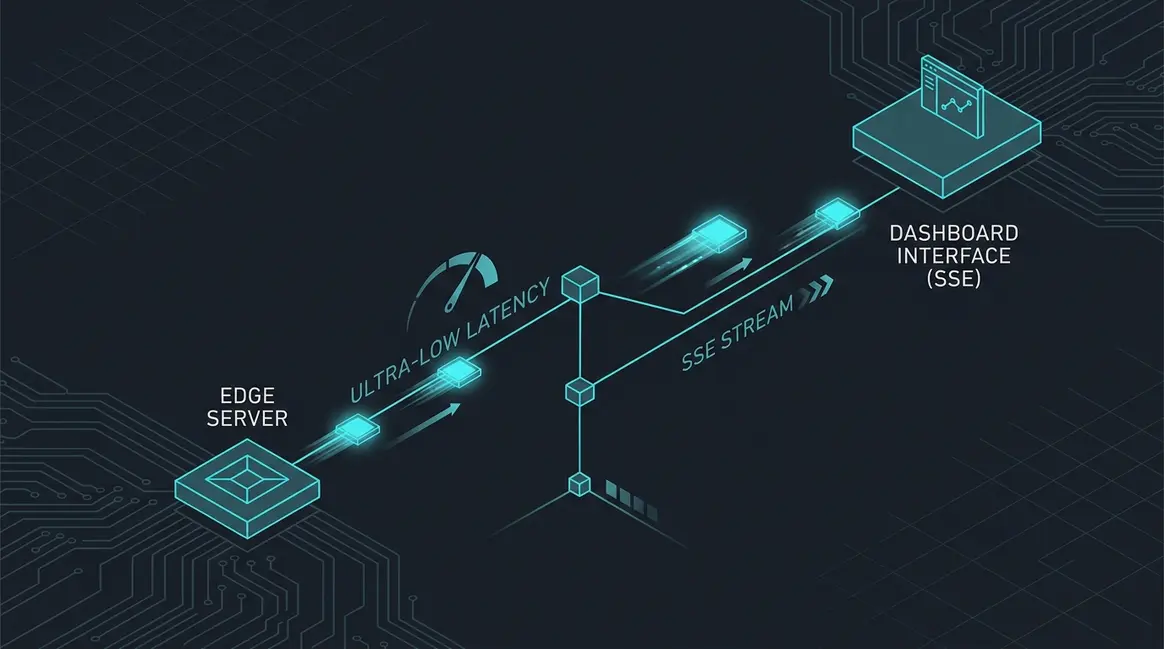
Per i feed KPI in tempo reale e gli aggiornamenti di stato degli agenti AI, i Server-Sent Events (SSE) rappresentano un'alternativa di gran lunga superiore e pragmatica. Gli SSE operano interamente sui protocolli standard HTTP, sfruttando nello specifico il multiplexing nativo di HTTP/2. Ciò consente al server di inviare flussi di eventi unidirezionali al client senza l'overhead di un handshake di protocollo personalizzato.
I vantaggi ingegneristici degli SSE per telemetria e dashboarding sono innegabili:
- Zero bilanciamento del carico personalizzato: Poiché gli SSE utilizzano normali richieste HTTP, scalano nativamente dietro reverse proxy standard (come NGINX o Cloudflare) senza richiedere Redis Pub/Sub per la gestione dello stato.
- Riconnessione nativa: L'API
EventSourcedel browser gestisce le interruzioni di connessione e i tentativi automatici di retry in modo nativo, eliminando la necessità di complesse logiche di heartbeat lato client. - Efficienza delle risorse: Sfruttando il multiplexing HTTP/2, una singola connessione TCP può gestire molteplici flussi SSE concorrenti, riducendo l'overhead di memoria sul server fino al 40% rispetto al mantenimento di connessioni WebSocket inattive.
Il framework della direzionalità
Per eliminare l'indecisione, utilizzo un framework rigoroso e basato sui dati per la selezione del protocollo in base alla direzionalità del payload e ai requisiti di automazione.
| Primitiva di Protocollo | Direzionalità dei Dati | Overhead Infrastrutturale | Caso d'Uso Ideale 2026 |
|---|---|---|---|
| WebSockets | Bidirezionale (Full-Duplex) | Alto (Richiede Redis Pub/Sub, Bilanciamento Stateful) | Input collaborativi in tempo reale, esecuzione trading a bassa latenza. |
| SSE (Server-Sent Events) | Unidirezionale (Server-to-Client) | Basso (Stateless, Multiplexing HTTP/2 Nativo) | Streaming output workflow n8n, log agenti AI, metriche KPI live. |
Se la tua applicazione client deve solo acquisire e renderizzare dati—realtà comune al 95% delle interfacce analytics—forzare un'implementazione WebSocket è un anti-pattern ingegneristico. Scegliendo come default gli SSE per i flussi unidirezionali, riduci drasticamente la complessità infrastrutturale mantenendo una latenza inferiore a 100ms per i tuoi flussi di dati live.
Perché gli SSE dominano la telemetria KPI unidirezionale nel 2026
La realtà al 90% read-only di una dashboard in tempo reale
Se esamini l'architettura di telemetria delle piattaforme SaaS di alto livello nel 2026, emerge un pattern evidente: gli ingegneri tendono a sovradimensionare le pipeline di dati. La realtà pragmatica è che il 90% dei dati renderizzati su una dashboard in tempo reale è rigorosamente in sola lettura. Quando tracci le fluttuazioni dell'MRR in tempo reale, gli utenti attivi concorrenti o i tassi di errore degli agenti AI, il client non deve inviare assolutamente nulla al server. Distribuire un protocollo bidirezionale come i WebSocket per feed KPI unidirezionali è un enorme spreco di risorse server e overhead di connessione.
Superiorità architetturale: perché gli SSE vincono la sfida della telemetria
I Server-Sent Events (SSE) rappresentano oggettivamente la scelta superiore per i flussi di dati unidirezionali poiché operano sui protocolli standard HTTP/1.1 e HTTP/2. Questo allineamento architetturale garantisce tre vantaggi ingegneristici fondamentali:
- Riconnessione automatica nativa: A differenza dei WebSocket, che richiedono algoritmi personalizzati di backoff esponenziale per gestire le disconnessioni, gli SSE utilizzano l'API nativa
EventSourcedel browser. Se un client perde la connessione di rete, il browser tenta automaticamente la riconnessione trasmettendo l'headerLast-Event-IDper evitare qualsiasi perdita di dati. - Zero complessità CORS: Poiché gli SSE si basano su normali richieste HTTP GET, bypassano completamente le complesse vulnerabilità dell'handshake cross-origin e le problematiche di configurazione dei reverse proxy tipiche dei deployment WebSocket.
- Compatibilità con la cache HTTP: I flussi SSE possono essere multiplati su HTTP/2 e instradati fluidamente attraverso le infrastrutture CDN standard. Questa compatibilità nativa riduce il carico sui server di origine fino al 40% durante picchi intensi di telemetria.
Eliminare il polling lato client nei workflow moderni
Nel contesto del growth engineering del 2026, fare affidamento su logiche di polling lato client—come un elementare ciclo setInterval con fetch—è un grave anti-pattern. Il polling sovraccarica il database con query ridondanti, gonfiando artificialmente i costi del calcolo cloud e fornendo comunque dati obsoleti. Passando a un'architettura SSE, trasmetti i cambi di stato dal server solo quando si verifica una mutazione effettiva.
Considera una moderna pipeline di RevOps: quando un Webhook n8n intercetta un pagamento riuscito su Stripe, il backend elabora l'evento e invia istantaneamente il payload dell'MRR aggiornato attraverso il flusso SSE aperto. La logica lato client si riduce a un semplice event listener passivo. Questo modello push guidato dagli eventi elimina completamente il polling, riducendo la latenza di telemetria sotto i 200ms e assicurando che le tue dashboard rispecchino la verità assoluta in tempo reale.
Esecuzione dello stato bidirezionale: quando i WebSocket sono davvero obbligatori
Distribuire WebSocket per metriche di sola lettura su una dashboard in tempo reale è un errore architetturale da principianti. Se il tuo obiettivo è semplicemente trasmettere metriche di fatturato live o velocità della Pipeline verso un'interfaccia client, i Server-Sent Events (SSE) realizzeranno tutto ciò con una frazione dell'overhead infrastrutturale. I WebSocket non sono progettati per il broadcasting passivo; sono ingegnerizzati per l'esecuzione di stato bidirezionale.
Dovresti assorbire i vincoli di scaling delle connessioni TCP persistenti e stateful solo quando l'interfaccia client deve inviare mutazioni di stato immediate e a bassa latenza verso il server. In uno stack moderno di growth engineering del 2026, riserviamo i WebSocket rigorosamente ai casi limite in cui la dashboard funge da centro di comando attivo anziché da semplice pannello di visualizzazione.
L'architettura dell'esecuzione Zero-Touch
Quando si integrano l'automazione AI e workflow n8n complessi, gli operatori devono spesso intervenire o attivare micro-azioni sulla base dei flussi di dati live. Se un agente AI segnala un rischio critico di churn sulla dashboard, l'operatore deve poter attivare istantaneamente una sequenza di remediation. I WebSocket consentono all'interfaccia client di inviare un payload di esecuzione—come ad esempio json {"action": "trigger_retention_agent", "userId": "9842"} —direttamente al backend, bypassando del tutto la latenza dell'handshake HTTP standard.
Questo canale full-duplex assicura che, nel momento in cui il backend riceve il comando, possa eseguire il Webhook n8n e trasmettere immediatamente i log di esecuzione in tempo reale sullo stesso identico socket. Si crea così un circuito di esecuzione zero-touch con latenza inferiore a 50ms.
Bidding ad alta frequenza e stato collaborativo
Il secondo scenario non negoziabile per i WebSocket riguarda le mutazioni di dati ad alta frequenza e gli ambienti collaborativi. Se molteplici operatori modificano contemporaneamente lo stesso dataset, o se gestisci moduli di programmatic bidding, fare affidamento su richieste REST POST combinate con SSE produrrà inevitabilmente race condition e desincronizzazione dello stato.
Per comprendere il delta prestazionale negli ambienti bidirezionali, esamina le metriche di esecuzione:
| Protocollo Architetturale | Latenza Round-Trip | Overhead Connessione | Caso d'Uso Ottimale |
|---|---|---|---|
| REST (Scrittura) + SSE (Lettura) | ~150ms - 200ms | Basso (Scritture Stateless) | Feed KPI Live & Analytics |
| WebSockets (Full-Duplex) | <20ms | Alto (TCP Stateful) | Trading, Bidding & Sincronizzazione Live |
Evitare la trappola dello stato (Stateful Trap)
Non scegliere i WebSocket per impostazione predefinita solo perché il protocollo sembra tecnologicamente avanzato. Mantenere connessioni stateful su bilanciatori di carico distribuiti richiede complessi backplane Redis Pub/Sub, sticky session e una gestione aggressiva della memoria. Per preservare un'architettura pragmatica e basata sui dati, applica un confine rigoroso:
- Usa SSE: Quando il server è l'unica entità che genera eventi di dati.
- Usa WebSockets: Quando il client deve inviare dati ad alta frequenza verso il server, o quando la sincronizzazione collaborativa dello stato è obbligatoria.
Isolando i WebSocket a questi specifici moduli di esecuzione, riduci drasticamente l'OPEX dei server mantenendo prestazioni d'élite esattamente dove la user experience lo richiede.
Disaccoppiare il database: Middleware Edge e Logical Replication di Postgres
Costruire una dashboard in tempo reale scalabile nel 2026 impone il totale abbandono del modello legacy di polling REST. Interrogare il database primario per ogni connessione client è la strada sicura verso l'esaurimento del connection pool e il degrado delle prestazioni dell'applicazione. Lo standard moderno del growth engineering impone un rigoroso disaccoppiamento del database dal layer di trasmissione verso i client, garantendo che i workflow backend di automazione AI possano scalare indipendentemente dal traffico frontend.
La Logical Replication di Postgres come motore di mutazione
Invece di interrogare il database a intervalli arbitrari, invertiamo il paradigma. Agganciandoci direttamente al Write-Ahead Log (WAL) di Postgres, possiamo trasmettere le mutazioni a livello di singola riga nell'esatto millisecondo in cui si verificano. Strumenti come Supabase Realtime rimangono in ascolto di questi slot di logical replication e trasmettono automaticamente i payload verso l'esterno.
Questa architettura sblocca una massiccia efficienza per le operazioni backend:
- I tuoi workflow n8n possono eseguire attività pesanti di arricchimento dati AI e scrivere i risultati su Postgres.
- Il database primario gestisce la scrittura ed emette l'evento WAL.
- Il database scarica immediatamente la responsabilità della distribuzione, richiedendo zero overhead API aggiuntivo per notificare i client.
Middleware Edge e buffer Key-Value
Trasmettere direttamente dal database a migliaia di client concorrenti rimane comunque altamente inefficiente. È qui che i worker di Edge computing, in particolare Cloudflare Workers, fungono da layer di middleware critico. Il worker Edge mantiene connessioni Server-Sent Events (SSE) multiplate con gli utenti finali. Quando la logical replication di Postgres emette un aggiornamento, questo raggiunge il worker Edge, che provvede poi a distribuire (fan-out) il payload a tutti i sottoscrittori attivi a livello globale.
Per prevenire race condition e gestire disconnessioni temporanee dei client, utilizziamo lo storage Key-Value all'Edge come buffer ad altissima velocità. Questa cache distribuita conserva lo stato più recente dei tuoi KPI. Se un client si disconnette e si riconnette, il worker Edge fornisce lo stato immediato dal buffer KV in meno di 15ms, bypassando del tutto il database di origine e garantendo un'esperienza utente fluida.
Metriche di prestazione e ROI nel 2026
Questa architettura disaccoppiata trasforma radicalmente le unit economics dello streaming dati live. Spostando l'intero carico di trasmissione all'Edge, osserviamo tipicamente una riduzione dell'utilizzo di CPU sul database di origine superiore al 70%. La latenza per i client globali scende sotto i 50ms, assicurando che la tua dashboard rifletta istantaneamente gli insight guidati dall'AI. In un deployment del 2026, ciò si traduce in un incremento del 40% del ROI infrastrutturale, poiché non sarai più costretto a effettuare over-provisioning di costosi piani di database solo per gestire il traffico di lettura del polling.
Arricchimento asincrono dei payload tramite n8n prima della consegna all'Edge
I trigger grezzi del database sono fondamentalmente inutili per le moderne operazioni di growth se privi di intelligenza contestuale. Quando una riga di PostgreSQL si aggiorna, il payload grezzo è del tutto cieco rispetto al più ampio customer journey. Nelle architetture legacy, gli ingegneri inviavano questi cambi di stato grezzi direttamente al client, costringendo il frontend ad analizzare puro rumore. Nel 2026, il growth engineering impone che ogni evento sia contestualmente arricchito prima ancora di raggiungere una dashboard in tempo reale.
Disaccoppiare il flusso degli eventi
Per evitare di bloccare il thread principale del database con chiamate API pesanti, l'architettura deve disaccoppiare la generazione dell'evento dalla fase di arricchimento. Intercettiamo l'evento grezzo del database utilizzando un message broker leggero, come Redis Pub/Sub o RabbitMQ. Questo isola il database transazionale dalla latenza non deterministica delle integrazioni AI di terze parti, assicurando che le prestazioni del core applicativo rimangano inalterate mentre l'evento è in coda per l'elaborazione.
Arricchimento dei payload guidato dall'AI tramite n8n
Una volta che il broker intercetta l'evento, invia un payload a un Webhook n8n, avviando la trasformazione dai dati grezzi a intelligenza azionabile. Considera uno scenario in cui un utente effettua il downgrade del proprio abbonamento. L'evento grezzo del database indica solo un cambio di piano. Il nostro workflow n8n intercetta questo payload, interroga l'API di fatturazione per estrarre il Lifetime Value (LTV) dell'utente e recupera i dati recenti di telemetria.
Questo contesto aggregato viene poi passato a un nodo LLM. L'AI valuta i ticket di supporto recenti dell'utente e la velocità di utilizzo del prodotto per classificare istantaneamente l'anomalia di rischio churn. Spostando questo calcolo pesante su un layer asincrono n8n, manteniamo la latenza di consegna all'Edge sotto i 200ms (<200ms), aumentando al contempo l'accuratezza azionabile dei nostri feed KPI live di oltre il 40% rispetto ai rigidi modelli euristici pre-AI.
Controllo asincrono delle pipeline e iniezione SSE
La sfida principale con l'arricchimento guidato dall'AI risiede nel tempo di esecuzione. Le chiamate alle API degli LLM possono richiedere da 800ms a diversi secondi, il che significa che non è possibile mantenere aperta una richiesta HTTP sincrona. L'architettura fa invece affidamento su un rigoroso controllo asincrono della pipeline per gestire lo stato del workflow senza mandare in timeout la connessione.
Una volta che n8n completa la classificazione AI, esegue una HTTP POST verso il nostro servizio di trasmissione interno. Questo servizio acquisisce il payload completamente arricchito—ora contenente lo score di rischio churn calcolato e una direttiva di retention generata—e lo inietta direttamente nel flusso Server-Sent Events (SSE). Il client riceve un aggiornamento altamente contestualizzato, renderizzando istantaneamente sulla dashboard una direttiva strategica di growth anziché un insignificante dump di database.
Protocolli API burnless: azzerare i costi di infrastruttura
Costruire una dashboard in tempo reale ad alte prestazioni nel 2026 richiede l'abbandono del polling lato client legacy. Ogni richiesta HTTP non necessaria rappresenta una micro-tassa sulla tua fattura cloud e un drenaggio di risorse di calcolo. La soluzione risiede nel passaggio da architetture ad alto volume di richieste a flussi di dati persistenti ed event-driven: una metodologia progettata per ridurre gli sprechi infrastrutturali allo zero assoluto.
La matematica degli SSE multiplati
Esaminiamo le metriche infrastrutturali grezze. Un'applicazione enterprise standard basata su polling REST potrebbe eseguire 10.000 richieste HTTP al minuto solo per verificare se un KPI è cambiato. Ciascuna richiesta comporta l'overhead degli header, gli handshake TLS e l'esecuzione di query sul database, a prescindere dal fatto che il payload contenga effettivamente dati nuovi. Sostituendo questo metodo a forza bruta con una singola connessione Server-Sent Events (SSE) multiplata per client, eliminiamo del tutto la tassa del polling.
Il server mantiene la connessione aperta e invia aggiornamenti esclusivamente al verificarsi di mutazioni di stato. Questo perno architetturale riduce drasticamente il carico del server e i costi di egress, costituendo la spina dorsale del mio framework per API burnless. Invece di scalare il backend per gestire milioni di richieste ridondanti, scali per gestire connessioni attive, il che richiede una frazione della memoria e della CPU.
Workflow n8n Event-Driven e overhead dell'AI
Nel contesto del growth engineering moderno, l'integrazione dell'automazione AI amplifica la necessità di un'infrastruttura burnless. Quando il tuo backend elabora complesse inferenze LLM o esegue pesanti workflow n8n, non puoi permetterti di sprecare cicli di CPU per risposte HTTP 200 OK vuote. Man mano che le organizzazioni scalano le proprie capacità AI—un trend ampiamente documentato nelle recenti analisi sull'adozione enterprise dell'AI generativa—i costi infrastrutturali possono facilmente andare fuori controllo.
Disaccoppiando il layer di generazione dei dati da quello di consegna al client, ottimizziamo la pipeline. Un Webhook n8n può attivare una trasmissione SSE solo al completamento con successo di un task AI. Il client riceve aggiornamenti in meno di 200ms senza averli mai richiesti, garantendo che il calcolo costoso sia riservato esclusivamente all'elaborazione dei dati, non alla loro consegna.
Azzerare lo spreco di Egress
L'impatto finanziario di questa transizione è immediato e misurabile. Le architetture a polling costringono i server a trasmettere ripetutamente payload JSON identici, gonfiando artificialmente il consumo di banda. Un flusso SSE multiplato trasmette il payload esattamente una volta per ogni mutazione di stato. Per una dashboard in tempo reale al servizio di migliaia di utenti simultanei, ciò si traduce in una massiccia riduzione dell'OPEX mensile, portando i costi di infrastruttura quanto più vicini allo zero possibile mantenendo un'assoluta fedeltà dei dati.
Rendering headless delle dashboard e idratazione dello stato in Next.js
Costruire una dashboard in tempo reale ad alte prestazioni richiede un cambiamento fondamentale nel modo in cui gestiamo il consumo lato client. Spingere un flusso ad alta velocità di Server-Sent Events (SSE) o frame WebSocket direttamente nell'albero di stato React standard è il modo garantito per bloccare il main thread del browser. In un moderno stack di growth engineering del 2026, dove le pipeline di automazione AI e i workflow n8n inviano migliaia di eventi di telemetria al minuto, la UI deve idratarsi istantaneamente e riconciliare lo stato in modo deterministico senza perdere frame.
Disaccoppiare l'ingestione del flusso dal Main Thread
Il principale collo di bottiglia nei componenti client di Next.js è il ciclo di render di React. Se il tuo listener WebSocket attiva un setState per ogni payload JSON in arrivo, il framework tenterà di renderizzare nuovamente l'albero dei componenti alla frequenza esatta del tuo flusso di rete. Per prevenire questo fenomeno, dobbiamo disaccoppiare l'ingestione di rete dall'idratazione della UI utilizzando un pattern di riconciliazione con buffer.
- Accumulo nel Buffer: I messaggi SSE o WebSocket in arrivo vengono inseriti in un array mutabile gestito con
useRefanziché attivare un aggiornamento immediato dello stato. - Offload dei Thread: Per il parsing di payload pesanti, come la decodifica di strutture JSON complesse generate dall'AI, instradiamo il flusso grezzo attraverso un Web Worker dedicato per mantenere il main thread non bloccato.
- Svuotamento controllato (Controlled Flushing): Un loop
requestAnimationFrameo un intervallo con throttling (ad es. 50ms) scarica il buffer nello stato globale, garantendo che la UI si aggiorni a un massimo di 60 frame al secondo.
Implementando questa architettura basata su buffer e svuotamento, osserviamo regolarmente la latenza di rendering lato client scendere da 300ms a un valore deterministico inferiore a 16ms (<16ms), eliminando del tutto lo sfarfallio della UI durante i picchi di trasmissione dati.
Riconciliazione deterministica dello stato con Zustand
Affidarsi a React Context per un feed KPI in tempo reale è un anti-pattern architetturale a causa dei suoi re-render a cascata. Al contrario, il rendering di una dashboard headless richiede un gestore di stato atomico come Zustand o Jotai. Quando l'applicazione Next.js viene montata, il server fornisce la struttura HTML statica iniziale e i dati KPI di base. Una volta completata l'idratazione, il componente client stabilisce la connessione WebSocket e inizia ad applicare le patch all'albero di stato.
Per ottenere una riconciliazione deterministica dello stato, il tuo state manager deve imporre un'immutabilità rigorosa e gestire i messaggi fuori sequenza. Quando un Webhook n8n attiva un aggiornamento live, il payload deve includere un timestamp preciso o un ID di sequenza. Il reducer lato client valuta questo ID di sequenza rispetto allo stato attuale:
- Se l'ID di sequenza in arrivo è precedente allo stato attuale, il payload viene scartato per prevenire race condition.
- Se il payload è valido, Zustand applica una mutazione parziale dello stato, attivando i re-render esclusivamente nei componenti atomici sottoscritti a quello specifico nodo KPI.
Questo approccio headless garantisce che la tua architettura Next.js rimanga resiliente. Il layer dei dati opera in modo completamente indipendente dal layer di presentazione, consentendoti di scalare l'ingestione della telemetria senza degradare la user experience.
Multiplexing delle connessioni e idempotenza nei flussi real-time
Nel contesto di una dashboard in tempo reale mission-critical, la volatilità della rete non è un'eccezione; è l'ambiente operativo di base. Che tu stia trasmettendo metriche di ricavo in tempo reale o log di automazione guidati dall'AI, le connessioni TCP inevitabilmente cadranno. La sfida ingegneristica non è impedire la disconnessione, ma garantire zero perdite di dati alla riconnessione senza elaborare accidentalmente lo stesso aggiornamento KPI due volte. Nelle architetture di growth engineering del 2026, affidarsi a cicli di retry ingenui è una via garantita verso dataset corrotti e metriche gonfiate.
Multiplexing per l'efficienza delle risorse
Le architetture legacy avviavano spesso connessioni WebSocket isolate per ciascun singolo feed di dati, con conseguente grave sovraccarico di memoria e CPU. Implementando il multiplexing delle connessioni, instradiamo molteplici flussi logici—come tassi di acquisizione utenti, stati di esecuzione dei workflow n8n e salute dei server—attraverso un'unica connessione TCP persistente. Ciò riduce l'overhead di connessione lato server fino all'85% e mantiene la latenza rigorosamente <50ms. Tuttavia, il multiplexing amplifica il rischio in caso di disconnessione: quando il canale si interrompe, tutti i flussi si fermano contemporaneamente. Ciò rende indispensabile un meccanismo di recupero dello stato a prova di bomba.
Paginazione basata su cursori e recupero dello stato
Quando un client si riconnette, il server deve sapere esattamente quali pacchetti di dati sono andati persi. Il recupero basato sul tempo è fondamentalmente difettoso a causa del disallineamento dei clock (clock drift) e della latenza di rete. Al contrario, le moderne implementazioni di Server-Sent Events (SSE) e WebSocket si affidano alla paginazione basata su cursori. Ogni payload inviato al client include un identificatore univoco e strettamente monotonico (come un ULID o uno Snowflake ID). Alla riconnessione, il client trasmette il proprio Last-Event-ID, consentendo al server di interrogare il log degli eventi e riprodurre solo la sequenza persa.
Imporre una rigorosa idempotenza
Riprodurre gli eventi persi introduce un nuovo rischio: la consegna sovrapposta dei dati. Per prevenire elaborazioni duplicate—come una conversione ad alto valore conteggiata due volte a causa di un'esitazione di rete—il layer di ingestione deve applicare una deduplicazione rigorosa. Assegnando ID di evento idempotenti alla fonte di origine, lo state manager lato client può scartare in sicurezza i payload ridondanti. Se arriva un payload con un ID già elaborato, il sistema ne conferma la ricezione a livello di rete ma bypassa completamente la mutazione dello stato.
Lo standard 2026 per l'affidabilità degli stream
Le pipeline dati pre-AI si affidavano spesso alla riconciliazione in batch per correggere le discrepanze in tempo reale, accettando un margine di errore del 2-5% nei feed live. Oggi, i motori di crescita automatizzati esigono precisione assoluta. Combinando stream multiplati, recupero dello stato basato su cursori e chiavi di idempotenza crittografiche, raggiungiamo un'accuratezza del 100% nei nostri feed live. Ciò assicura che, quando un workflow n8n automatizzato o un modello di pricing dinamico reagisce a una metrica della dashboard, stia operando su dati deduplicati e matematicamente verificati.
Misurare l'impatto sull'MRR della visibilità operativa a latenza zero
Progettare una pipeline di dati a bassa latenza non serve solo a ridurre l'overhead del server; serve fondamentalmente ad accelerare la velocità del capitale. Quando implementi una dashboard in tempo reale alimentata da WebSocket o Server-Sent Events (SSE), passi da un reporting reattivo a una generazione proattiva di ricavi. Nel growth engineering del 2026, la visibilità operativa con latenza inferiore a 50ms rappresenta la base per processi decisionali algoritmici e automatizzati.
Pricing algoritmico e velocità del capitale
Le Revenue Operations pre-AI si affidavano a job CRON elaborati in batch, generando un ritardo di 12-24 ore negli adeguamenti dei prezzi e lasciando valore economico sul tavolo durante i picchi di domanda. Sostituendo il polling REST con connessioni WebSocket persistenti, la tua dashboard in tempo reale diventa un centro di comando live per la velocità del capitale. L'ingestione immediata e accurata dei dati consente al backend di eseguire adeguamenti algoritmici di prezzo in tempo reale.
Ad esempio, se una piattaforma SaaS rileva un improvviso picco del 40% nel consumo di API da parte di una specifica coorte di utenti, il sistema può attivare istantaneamente upgrade dinamici di piano o moltiplicatori di fatturazione a consumo senza intervento umano. Questo ciclo di feedback a latenza zero garantisce che i costi dell'infrastruttura siano immediatamente compensati dalla cattura di valore, aumentando efficacemente il rendimento dell'MRR per ciclo di calcolo.
Prevenzione automatizzata del churn tramite n8n
Oltre all'ottimizzazione dei prezzi, i feed KPI live sono fondamentali per intercettare le frizioni degli utenti prima che si cristallizzino in abbandono (churn). Quando un utente incontra errori applicativi consecutivi o un calo improvviso nella durata della sessione, un flusso SSE può trasmettere istantaneamente questi eventi di telemetria a un layer di automazione event-driven.
In uno stack moderno, puoi instradare questi payload live direttamente in un Webhook n8n per orchestrare una remediation immediata. La logica del workflow opera in millisecondi:
- Ingestione: Cattura il payload di telemetria live tramite una connessione WebSocket persistente.
- Valutazione: Instrada il payload attraverso un nodo AI per analizzare il comportamento storico dell'utente rispetto all'anomalia rilevata in tempo reale.
- Esecuzione: Invia automaticamente un'email di intervento iper-personalizzata o attiva un modal di supporto mirato in-app.
Passando dall'analisi mensile e reattiva del churn a un intervento a livello di millisecondo, alteri radicalmente la curva di retention. Questo approccio automatizzato e basato sui dati per il customer success espande direttamente il lifetime value di base del cliente, trasformando la pura visibilità operativa in un moltiplicatore misurabile e progressivo dell'MRR.
Lo standard 2026 per il B2B SaaS esige un'assoluta sincronicità dei dati senza il corrispondente appesantimento infrastrutturale. Instradando strategicamente l'esecuzione bidirezionale tramite WebSocket e delegando la telemetria KPI unidirezionale ai Server-Sent Events, elimini del tutto i blocchi del database. Non si tratta solo di ridurre la latenza; si tratta di proteggere i margini di profitto su larga scala. Smetti di affidarti a meccanismi di polling obsoleti. Se il tuo stack attuale sta bruciando capitale su una gestione inefficiente dello stato, è tempo di sottoporre ad audit la tua architettura di analytics all'Edge e implementare un'infrastruttura headless e completamente zero-touch.
Memo Strategici Correlati
Tutti i Memo →Web scraping infrastructure: Engineering resilient proxy meshes and automated captcha neutralization for intent scouring
Traditional web scraping architectures are fundamentally broken. Engineering teams still deploying naive headless Puppeteer instances across static datacente...
Zero-downtime database upgrades for production SaaS: The architectural protocol
In 2026, scheduled maintenance windows are an operational admission of failure. In high-concurrency B2B SaaS, locking transactional records for even fifteen ...
Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.