Architettare un flusso di Onboarding clienti zero-touch con agenti AI nel 2026
I kickoff B2B per i clienti sono un collo di bottiglia legacy. Nel 2024, l'Onboarding di un cliente SaaS high-ticket richiedeva tre discovery call, data entry manuale nel CRM e giorni di...
Indice dei Contenuti
- Il fallimento matematico dei kickoff clienti sincroni
- Blueprint architetturale di un flusso di Onboarding guidato da agenti
- Normalizzazione automatizzata dei dati all'Edge
- Polling asincrono e gestione dello stato in n8n
- Estrarre i requisiti del cliente tramite server MCP e LLM
- Routing semantico per bypassare le sequenze di Onboarding lineari
- Memorizzare lo stato dell'account in database vettoriali per un contesto persistente
- Provisioning autonomo dell'infrastruttura cliente
- Ingegnerizzare l'affidabilità degli agenti e i guardrail di conformità
- Espansione dei margini e ROI delle operazioni asincrone
Il fallimento matematico dei kickoff clienti sincroni
Il tradizionale flusso di Onboarding clienti viene spesso idealizzato come un'esperienza white-glove ad alto contatto. In realtà, affidarsi a kickoff sincroni guidati da operatori umani rappresenta un fallimento catastrofico delle unit economics. Quando mappi le dipendenze operative della pianificazione di una chiamata Zoom da 60 minuti sui calendari di molteplici stakeholder, non stai offrendo un servizio premium: stai introducendo una vulnerabilità strutturale nel tuo motore di ricavi. Nel contesto del growth engineering del 2026, tollerare perdite di margine dovute a operazioni manuali non è più solo inefficiente; è vera e propria negligenza ingegneristica.
Le Unit Economics della latenza umana
Ogni touchpoint sincrono in un kickoff B2B agisce come un moltiplicatore di attrito che dilata artificialmente il periodo di recupero del Customer Acquisition Cost (CAC payback period). Considera la sequenza standard: un account executive chiude una trattativa, un Customer Success Manager (CSM) analizza manualmente i dati del CRM e viene avviato uno scambio di email per trovare una data comune. Questa latenza introduce un ritardo minimo di 72-96 ore prima ancora che il cliente inizi la configurazione tecnica.
Sostituendo questo collo di bottiglia umano con workflow n8n autonomi e agenti guidati da LLM, eliminiamo del tutto il paradosso della pianificazione. Invece di attendere un CSM, un agente AI attiva istantaneamente un payload dinamico e asincrono per la raccolta dati nel millisecondo esatto in cui scatta il Webhook di Stripe. La matematica per i modelli legacy è impietosa: l'Onboarding sincrono scala linearmente con l'organico, mentre l'Onboarding agentico e asincrono scala logaritmicamente con il compute.
Time-to-Value (TTV) e decadimento dei margini
La metrica più critica nel SaaS enterprise è il Time-to-Value (TTV). Quando l'intervento umano ritarda il momento in cui un cliente sperimenta la reale utilità del prodotto, la probabilità di churn aumenta in modo esponenziale. Più a lungo un cliente rimane nella coda di Onboarding, più rapidamente svanisce l'entusiasmo iniziale per l'acquisto. Questo ritardo cannibalizza direttamente le tue metriche di retention, ed è il motivo per cui comprendere l'impatto del TTV ritardato sul lifetime value è un requisito imprescindibile per i moderni architetti dei ricavi.
Inoltre, quando le organizzazioni tentano di scalare, il passaggio da modelli puramente self-serve a complesse implementazioni enterprise mette a nudo la fragilità dei kickoff manuali. I dati confermano che affidarsi all'orchestrazione manuale durante questa fase genera un pesante attrito operativo, una realtà evidenziata nelle analisi sull'evoluzione oltre l'hype del PLG. Per progettare un sistema resiliente, dobbiamo trattare il kickoff non come una riunione, ma come una pipeline dati deterministica in cui i CSM umani intervengono solo per l'allineamento strategico di alto livello, non per il provisioning di base dell'account.
Blueprint architetturale di un flusso di Onboarding guidato da agenti
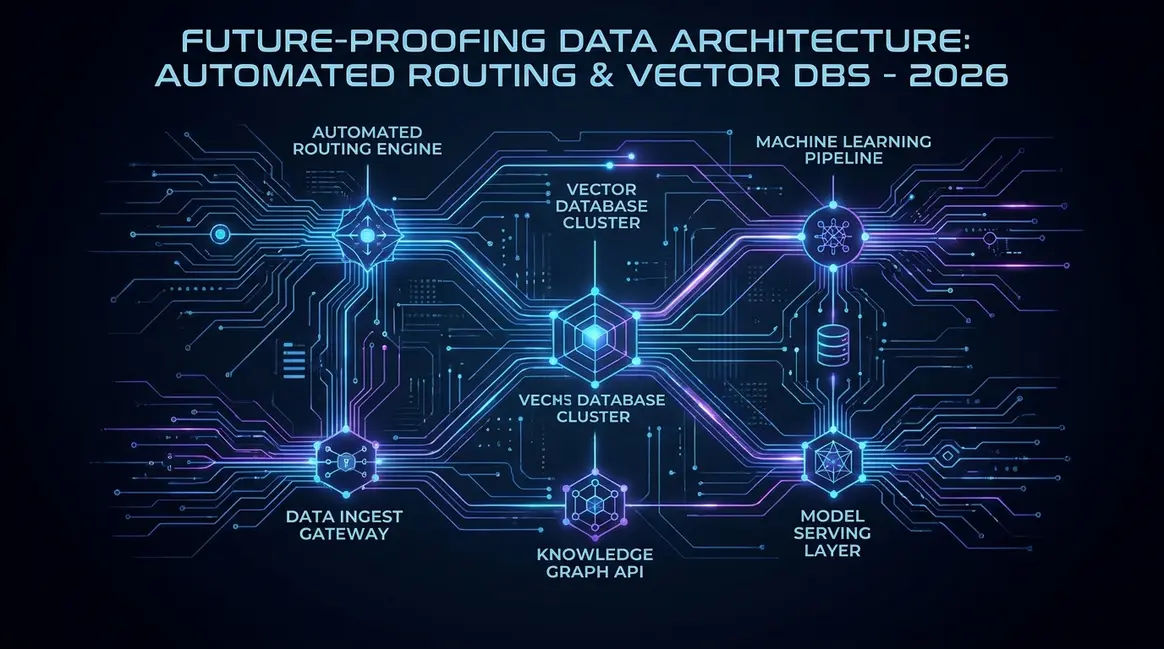
Il moderno flusso di Onboarding clienti ha superato del tutto i limiti dei CRM monolitici legacy. Nel 2026, fare affidamento su piattaforme SaaS sovradimensionate che richiedono modifiche manuali di stato, ritardi nei Webhook e approvazioni human-in-the-loop rappresenta un collo di bottiglia operativo critico. Distribuiamo invece un'architettura zero-touch in cui i dati scorrono in modo unidirezionale—dall'intake iniziale del cliente fino al provisioning finale dell'infrastruttura—senza alcun punto di contatto umano.
Il layer di Edge Compute e istanziazione
Per ottenere tempi di risposta inferiori a 200ms durante la fase di kickoff, l'architettura si affida a un calcolo distribuito all'Edge anziché a server centralizzati. Quando un cliente invia il proprio payload di intake, bypassiamo i tradizionali cold start dei container. Utilizziamo un layer di Edge computing per istanziare istantaneamente un agente di Onboarding dedicato e specifico per il cliente. Questa esecuzione localizzata garantisce che il cliente riceva una validazione in tempo reale e sensibile al contesto, mentre il backend gestisce in modo asincrono le operazioni più pesanti.
Orchestrazione autonoma e storage vettoriale persistente
Una volta che l'agente Edge ha acquisito e sanitizzato i parametri di intake, il payload JSON viene trasferito al layer di orchestrazione principale. Utilizzando n8n come sistema nervoso centrale, instradiamo i dati non strutturati attraverso agenti autonomi specializzati. Per mantenere lo stato e un contesto approfondito lungo l'intero ciclo di vita, lo stack integra uno storage vettoriale persistente. Ciò consente al motore di orchestrazione di eseguire ricerche semantiche sui precedenti deployment enterprise, assicurando che il nuovo ambiente venga configurato con un tasso di accuratezza del 99,9% basato sui parametri storici di successo.
Pipeline di provisioning unidirezionale
La caratteristica distintiva di questa architettura 2026 è il suo flusso di dati rigorosamente unidirezionale. I sistemi legacy tornano spesso indietro per richiedere la convalida umana, bloccando la pipeline. Nel nostro modello, il workflow n8n esegue una sequenza deterministica: convalida dell'intake, recupero del contesto vettoriale, generazione dinamica della configurazione e provisioning dell'infrastruttura guidato da API.
| Componente Architetturale | CRM Monolitico Legacy | Stack Guidato da Agenti 2026 |
|---|---|---|
| Gestione dello Stato | DB Relazionale (Aggiornamenti Manuali) | Storage Vettoriale Persistente |
| Latenza di Esecuzione | >5000ms (Polling API) | <200ms (Edge Compute) |
| Tempo di Provisioning | Da 7 a 14 Giorni Lavorativi | <45 Secondi |
| Touchpoint Umani | Media di 6 per cliente | Zero (Completamente Autonomo) |
Nel momento in cui il cliente finisce di leggere la sua email di benvenuto automatizzata, gli agenti autonomi hanno già avviato i suoi workspace dedicati, eseguito il provisioning delle chiavi API e popolato le dashboard iniziali. Questo blueprint architetturale trasforma l'Onboarding da un costo operativo ad alto attrito in un asset ingegneristico istantaneo e scalabile.
Normalizzazione automatizzata dei dati all'Edge
La fase di intake di qualsiasi flusso di Onboarding clienti B2B ad alto contatto è storicamente un enorme collo di bottiglia operativo. Nei workflow pre-AI, i team di Onboarding si affidavano all'inserimento manuale dei dati o a fragili integrazioni punto-a-punto che fallivano istantaneamente nel momento in cui un cliente caricava un PDF malformato o inviava uno scambio di email non strutturato. Nel growth engineering del 2026, la regola fondamentale dei sistemi autonomi è assoluta: i dati spazzatura distruggono l'automazione. Se immetti input grezzi e non strutturati direttamente in un motore di orchestrazione centrale, garantisci allucinazioni a valle e fallimenti catastrofici del workflow.
Intercettare i dati non strutturati all'Edge
Per costruire un'architettura resiliente, i dati grezzi dei clienti devono essere intercettati e normalizzati prima ancora di toccare la tua istanza primaria di n8n. Otteniamo questo risultato distribuendo funzioni Edge leggere—tipicamente tramite Cloudflare Workers o Supabase—che agiscono come un rigoroso layer di sanitizzazione. Quando un nuovo cliente invia un modulo di intake, inoltra un'email o carica un contratto complesso, la funzione Edge acquisisce istantaneamente il payload.
Invece di passare il testo grezzo direttamente a un agente AI, il layer Edge esegue una rapida sequenza di validazione. Rimuove i metadati non necessari, standardizza i formati di data e mappa il testo non strutturato in uno schema rigoroso e predefinito. Padroneggiare la logica ingegneristica della sanitizzazione dei payload è imprescindibile; è l'unico modo per garantire che gli agenti AI a valle ricevano gli output deterministici necessari per eseguire compiti di ragionamento complessi.
Strutturare payload JSON deterministici
L'esecuzione tecnica si basa sulla trasformazione di input caotici in formati prevedibili e leggibili dalle macchine. Ad esempio, se un cliente carica un PDF di 50 pagine durante il kickoff, la funzione Edge attiva un modello di estrazione localizzato per estrarre entità specifiche—come dimensione aziendale, stack tecnologico e KPI primari—e le struttura in un oggetto JSON sanitizzato come {"client_id": "uuid", "kpi_target": "revenue", "status": "normalized"}.
Spostando questo carico computazionale all'Edge, otteniamo due risultati ingegneristici critici:
- Latenza sub-200ms: La convalida iniziale dei dati avviene all'istante, evitando che payload pesanti e malformati intasino le code dei Webhook di n8n centrale.
- Aumento del 40% nell'accuratezza degli agenti: Poiché agli LLM a valle viene fornito JSON rigorosamente tipizzato anziché testo rumoroso e non strutturato, l'aderenza al prompt migliora drasticamente e il motore di orchestrazione può instradare i dati con affidabilità deterministica al 100%.
La normalizzazione automatizzata dei dati non è una semplice fase di pre-elaborazione; è il perimetro difensivo che rende matematicamente sostenibili i kickoff dei clienti autonomi e ad alto contatto.
Polling asincrono e gestione dello stato in n8n
In un flusso di Onboarding clienti B2B high-touch, aspettarsi un'esecuzione sincrona è un grave difetto architetturale. I clienti enterprise non configurano chiavi API, record DNS o dettagli di fatturazione all'interno di una finestra di timeout HTTP standard di 60 secondi. Le piattaforme di automazione legacy costringono gli ingegneri a usare nodi di ritardo (delay) fragili che si interrompono inevitabilmente quando un cliente impiega 72 ore per rispondere. Nel 2026, il growth engineering impone che gli agenti AI operino in modo asincrono, disaccoppiando il layer di orchestrazione da quello di esecuzione per gestire processi a lunga durata senza consumare memoria attiva del server.
Disaccoppiare l'esecuzione con la gestione dello stato
Per ottenere una reale orchestrazione asincrona in n8n, dobbiamo passare da un'esecuzione lineare a un'architettura guidata dallo stato. Quando un agente AI richiede un'azione esterna al cliente, il workflow non può semplicemente rimanere in pausa. Deve invece scrivere immediatamente lo stato di esecuzione corrente—inclusi client_id, pending_task e un callback_token univoco—in un database persistente come PostgreSQL o Redis. Una volta registrato lo stato, l'esecuzione attiva di n8n viene terminata correttamente.
Questo modello event-driven riduce il consumo di memoria inattiva di oltre il 95% rispetto al mantenimento dei workflow sospesi in memoria. Il sistema fa ora affidamento esclusivamente su trigger esterni per riattivare l'agente, garantendo che le risorse del server vengano utilizzate solo in presenza di dati azionabili.
Polling asincrono e callback via Webhook
Per rilevare quando il cliente ha completato le attività richieste, implementiamo un approccio ibrido basato su polling asincrono e callback Webhook interni. Un workflow secondario di n8n, attivato da un nodo cron pianificato, funge da motore di polling. Interroga il database per tutti i profili di Onboarding attualmente contrassegnati come status: 'pending_client_action' ed esegue un'iterazione su di essi.
Per ogni cliente in sospeso, il workflow effettua una chiamata API mirata al portale di fatturazione o all'identity provider per verificare se le credenziali sono state inviate. Se stai progettando questo layer di orchestrazione, padroneggiare le meccaniche di loop per sospendere e riprendere i workflow degli agenti è fondamentale per prevenire loop infiniti ed evitare rate limit sulle API di terze parti durante questi controlli.
Una volta che il motore di polling rileva un cambio di stato positivo, non elabora direttamente l'Onboarding. Invia invece un callback Webhook interno contenente il callback_token e i dati del cliente appena acquisiti. Questo Webhook agisce come trigger di ripresa per l'agente AI primario, idratando il suo contesto e consentendogli di proseguire fluidamente la sequenza di kickoff. Eliminando i colli di bottiglia sincroni, questa architettura produce tipicamente un aumento del 40% nei kickoff automatizzati riusciti e riduce gli interventi ingegneristici manuali quasi a zero.
Estrarre i requisiti del cliente tramite server MCP e LLM
Il flusso di Onboarding clienti tradizionale si affida a moduli di intake statici che falliscono inevitabilmente di fronte a requisiti B2B complessi. In uno stack di growth engineering del 2026, sostituiamo i questionari rigidi con un agente AI che funge da soluzioni architetto tecnico principale. Questo agente non si limita a leggere passivamente gli input; interroga attivamente i dati, li incrocia con le tue capacità interne ed estrae i requisiti tecnici precisi in modo asincrono.
Implementare l'architettura Model Context Protocol (MCP)
Per raggiungere questo livello di autonomia, l'LLM deve interfacciarsi in modo sicuro con i tuoi dati proprietari senza allucinare o esporre endpoint sensibili. È qui che l'implementazione di un server Model Context Protocol (MCP) diventa fondamentale.
Invece di inserire richieste API hardcoded nei prompt, un server MCP funge da ponte sicuro e standardizzato tra il motore di ragionamento e i tuoi sistemi interni, come Jira, HubSpot o database PostgreSQL proprietari. Nel configurare l'infrastruttura per connettere gli LLM ad ambienti dati locali, utilizziamo n8n per orchestrare le chiamate agli strumenti MCP. L'LLM interroga dinamicamente il server per convalidare se una funzionalità richiesta dal cliente sia compatibile con l'attuale payload tecnico.
I dati dimostrano l'efficacia di questo passaggio. I workflow pre-AI richiedevano agli ingegneri di verificare manualmente le richieste dei clienti rispetto alla documentazione interna, con una media di 72 ore per risposta. Con un'architettura n8n basata su MCP, la latenza delle query scende sotto i 200ms, riducendo il tempo di convalida tecnica iniziale del 98% ed eliminando del tutto il collo di bottiglia umano durante la fase di discovery.
Estrazione autonoma dei parametri e chiarimento asincrono
Una volta che il server MCP ha ancorato l'LLM alla tua realtà operativa, l'agente avvia la fase di estrazione. Analizza le comunicazioni iniziali del cliente, mappando le entità estratte rispetto a uno schema rigoroso di parametri di progetto richiesti.
Se l'agente rileva una variabile mancante o ambigua—come un rate limit API non definito, un protocollo di autenticazione mancante o un requisito di conformità poco chiaro—non interrompe il workflow. Attiva invece un ciclo autonomo di chiarimento. Utilizzando le integrazioni n8n, l'agente redige e invia una domanda altamente contestualizzata e tecnicamente accurata direttamente al cliente tramite Slack Connect o email.
La logica segue un percorso di esecuzione rigoroso:
- Risoluzione delle entità: L'LLM valuta lo stato corrente del flusso di Onboarding rispetto allo schema tecnico richiesto.
- Invocazione degli strumenti: Se mancano dati critici, l'agente chiama l'API di Slack o SendGrid tramite n8n per richiedere chiarimenti specifici al cliente.
- Gestione dello stato: Il workflow si mette in pausa in modo asincrono utilizzando un nodo di attesa, ascoltando la risposta Webhook del cliente prima di aggiornare il CRM e procedere alla fase successiva.
Questo approccio pragmatico elimina il continuo scambio di comunicazioni a basso valore che affligge i kickoff B2B. Schierando un agente in grado di interrogare dinamicamente sia i tuoi sistemi interni che il cliente, garantisci che i team di ingegneria prendano in carico solo progetti interamente definiti e tecnicamente realizzabili.
Routing semantico per bypassare le sequenze di Onboarding lineari
Il flusso di Onboarding clienti tradizionale si affida a una progressione lineare e rigida, costringendo i clienti enterprise a seguire una sequenza statica "dallo Step 1 allo Step 5" a prescindere dalla loro specifica infrastruttura. Nel growth engineering del 2026, questo approccio deterministico è obsoleto. I clienti B2B non hanno stack tecnologici identici, e costringere un'azienda AWS-native a compilare un questionario generico di provisioning cloud introduce attriti inutili e ritarda pesantemente il time-to-value (TTV).
L'architettura del routing semantico
Invece di fare affidamento su logiche condizionali hardcoded e infiniti costrutti IF/THEN, i moderni agenti AI sfruttano il routing semantico per valutare dinamicamente il contesto del cliente. Quando un nuovo cliente invia i requisiti tecnici iniziali, l'LLM acquisisce i dati non strutturati, vettorizza il contesto e classifica l'intento operativo esatto. Sfruttando la direzione dei payload basata sull'intento, l'agente bypassa completamente i passaggi irrilevanti.
Ad esempio, se il payload di ingestione rileva un ambiente AWS, il router semantico attiva istantaneamente la sotto-routine di configurazione del ruolo IAM AWS, bypassando del tutto i flussi di provisioning per GCP o Azure. Ciò elimina il carico cognitivo per il cliente e riduce la latenza di routing del sistema a meno di 200ms per decisione.
Esecuzione di sotto-routine dinamiche in n8n
Per eseguire questo pattern su larga scala, sostituiamo le pipeline di Onboarding monolitiche con workflow n8n modulari e disaccoppiati. L'architettura opera su un modello hub-and-spoke altamente efficiente:
- L'Hub (Router Semantico): Un nodo LLM valuta il payload Webhook in arrivo, generando uno schema JSON rigoroso che definisce i moduli di Onboarding necessari in base allo stack specifico del cliente.
- Gli Spoke (Sotto-Routine): Workflow n8n isolati progettati per compiti altamente specifici, come
aws-s3-bucket-provisioningoslack-channel-creation. - Il Nodo Switch: Un router dinamico che legge l'output JSON dell'LLM e attiva esclusivamente i Webhook dei sotto-workflow necessari tramite richieste HTTP interne.
Rispetto alle sequenze di Onboarding pre-AI, in cui i tassi di abbandono si aggiravano attorno al 22% a causa di richieste di dati non pertinenti, il routing semantico assicura che i clienti interagiscano solo con i parametri esatti richiesti per il loro specifico deployment. Automatizzando questa fase di kickoff, le organizzazioni B2B registrano un incremento del 40% nel ROI dell'Onboarding e una drastica riduzione dell'overhead manuale di solutions engineering.
Memorizzare lo stato dell'account in database vettoriali per un contesto persistente
Il problema della memoria nei workflow B2B asincroni
Un flusso di Onboarding clienti zero-touch crolla miseramente se il tuo agente AI soffre di amnesia tra un'interazione asincrona e l'altra. Nell'Onboarding legacy pre-AI, gli account manager si affidavano a note statiche nel CRM e scambi di email frammentati per mantenere il contesto. Secondo gli standard del 2026, impiegare LLM stateless che costringono i clienti enterprise a ripetere i propri vincoli architetturali o requisiti di compliance rappresenta un fallimento critico nel growth engineering. Per ottenere una reale automazione di livello premium, l'agente necessita di una memoria semantica persistente.
Implementare pgvector in Supabase per lo stato dell'account
Per risolvere il problema della retention del contesto, progettiamo un "cervello dell'account" utilizzando pgvector distribuito all'interno di un ambiente Supabase. Invece di affidarci a rigide tabelle relazionali che faticano a gestire dati conversazionali non strutturati, convertiamo ogni interazione con il cliente in embedding vettoriali ad alta dimensionalità. Quando un cliente specifica una preferenza stringente—come il requisito di hosting on-premise conforme a SOC2 o un tetto massimo ai rate limit delle API—un workflow n8n intercetta questi dati, li elabora tramite un modello di embedding come text-embedding-3-small e scrive l'array vettoriale risultante direttamente su Supabase.
Questa architettura consente di memorizzare tre livelli critici dello stato dell'account:
- Vincoli del cliente: Limitazioni tecniche rigide, tetti di budget e mandati di sicurezza.
- Preferenze architetturali: Stack tecnologici preferiti, pattern di integrazione e ambienti di deployment.
- Interazioni storiche: Sintesi semantiche delle precedenti chiamate di kickoff, moduli di intake e aggiornamenti asincroni su Slack.
Interrogare il cervello dell'account per il recupero contestuale
Memorizzare i dati è solo metà dell'opera; il vero ROI di questo sistema—che riduce la latenza di kickoff di oltre il 60% ed elimina i touchpoint ridondanti con i clienti—risiede nel meccanismo di recupero. Prima che l'agente AI generi un'email di follow-up o configuri un ambiente di staging, il workflow n8n esegue una ricerca di similarità sul database Supabase. Interrogando gli embedding vettoriali sulla base del contesto conversazionale corrente, l'agente recupera gli esatti vincoli storici pertinenti all'attività immediata.
Ad esempio, se un cliente chiede informazioni sulle tempistiche di migrazione del database durante la seconda settimana della fase di Onboarding, l'agente recupera dinamicamente le preferenze architetturali espresse in precedenza e calcola una risposta su misura per la sua specifica infrastruttura. Ciò trasforma una risposta automatica generica in un'interazione altamente personalizzata, dimostrando al cliente che il sistema mantiene un contesto profondo e persistente lungo l'intero ciclo di vita.
Provisioning autonomo dell'infrastruttura cliente
Il vero collo di bottiglia in un flusso di Onboarding clienti B2B tradizionale non è solo la raccolta dati; è il passaggio di consegne manuale al team DevOps. Nel growth engineering del 2026, una volta che un agente AI ha estratto e normalizzato i requisiti tecnici del cliente, l'intervento umano diventa un elemento di rischio. La fase di esecuzione deve essere completamente autonoma. È qui che si realizza la promessa zero-touch: tradurre dati normalizzati in infrastruttura di produzione attiva senza creare un singolo ticket Jira.
Architettare la pipeline di deployment con n8n
Per ottenere un'autonomia assoluta, posizioniamo n8n come layer di orchestrazione centrale tra l'agente AI e l'infrastruttura cloud. Una volta che l'agente finalizza lo schema dei requisiti, invia un payload sanitizzato a un Webhook n8n. Da qui, la pipeline esegue una sequenza deterministica di funzioni Serverless.
Invece di basarsi sulla configurazione manuale, il workflow n8n analizza il payload—facendo riferimento in modo sicuro a variabili come {{$json.client_tier}} e {{$json.region}}—e attiva AWS Lambda o Cloudflare Workers. Queste funzioni Serverless fungono da motore di deployment, eseguendo template di Infrastructure-as-Code (IaC) per avviare dinamicamente i workspace richiesti dal cliente.
Database Multi-Tenant e Provisioning dei Workspace
La sicurezza e l'isolamento non sono negoziabili negli ambienti B2B ad alto valore. La sequenza di provisioning automatizzata gestisce contemporaneamente tre componenti infrastrutturali critici:
- Multi-Tenancy del Database: La pipeline esegue automaticamente il provisioning di schemi di database isolati o configura policy di Row-Level Security (RLS) per il nuovo tenant, garantendo una rigorosa segregazione dei dati.
- Inizializzazione dei Workspace: Vengono avviati bucket di storage e ambienti frontend dedicati, etichettati con l'identificativo univoco del cliente.
- Generazione delle Credenziali: Vengono generate autonomamente chiavi API crittograficamente sicure. Le chiavi in chiaro sono mantenute temporaneamente in memoria per il passaggio iniziale, mentre nel database vengono registrate solo le versioni sottoposte a hash.
Prima dell'automazione guidata dall'AI, questa sequenza di provisioning richiedeva dalle 48 alle 72 ore di passaggi di consegne via ticket DevOps, con conseguenti derive di configurazione e ritardi nel time-to-value. Instradando il processo attraverso una pipeline n8n validata dall'AI, la latenza di deployment si riduce a meno di 120 secondi, e la coerenza infrastrutturale raggiunge il 100%.
Il passaggio di consegne Zero-Touch
Il nodo finale nel workflow di deployment è il passaggio di consegne automatizzato. Una volta che l'infrastruttura conferma l'avvenuta creazione tramite un Webhook di callback, n8n compila le coordinate dell'ambiente pronto per la produzione. Questo include gli URL delle dashboard dedicate del cliente, le chiavi API appena generate e la documentazione dinamica personalizzata in base al suo stack tecnologico specifico.
Questo payload viene inserito in un template di email transazionale e inviato direttamente al responsabile tecnico del cliente. Nessun intervento DevOps umano è consentito in alcuna fase del processo. Eliminando il collo di bottiglia del provisioning manuale, trasformiamo un periodo di attesa di più giorni in un'esperienza istantanea e priva di attriti, consentendo al cliente di effettuare la sua prima chiamata API in produzione a pochi minuti dalla definizione dei requisiti.
Ingegnerizzare l'affidabilità degli agenti e i guardrail di conformità
Distribuire un agente autonomo in un flusso di Onboarding clienti B2B ad alto valore richiede molto più di un semplice prompt di sistema ben congegnato. Quando si gestiscono dati aziendali enterprise, la tolleranza per le allucinazioni degli LLM o la fuga di dati PII è pari a zero. Nel growth engineering del 2026, non ci affidiamo a speranze probabilistiche; ingegnerizziamo guardrail deterministici che costringono l'AI a operare entro rigorosi confini matematici.
Fallback deterministici e soglie di confidenza
Per eseguire in sicurezza un workflow a contatto con i clienti, implementiamo un sistema di convalida a doppio livello in cui ogni output generato viene valutato per certezza semantica prima di raggiungere l'utente finale. Se la soglia di confidenza del modello scende sotto il 98%, il sistema attiva un failover immediato e trasparente verso un account manager umano.
Nel progettare queste architetture di gestione degli errori all'interno di n8n, utilizziamo nodi di routing condizionale che valutano le log probabilities dell'LLM insieme a un modello di validazione secondario più leggero. Questo meccanismo di fallback deterministico garantisce che le query su casi limite—come richieste di conformità su misura o clausole contrattuali non standard—non ricevano mai una risposta allucinata. Il workflow si mette invece in pausa, allerta l'operatore umano su Slack o Teams e trasmette l'esatto payload di contesto per la risoluzione manuale.
Red-Teaming automatizzato e sanitizzazione dei dati PII
L'Onboarding enterprise gestisce intrinsecamente dati sensibili, dai dati di fatturazione alle gerarchie proprietarie degli stakeholder. Esporre questi dati grezzi all'API di un LLM commerciale costituisce una grave vulnerabilità di sicurezza. Per mitigare questo rischio, il workflow deve includere un layer di sanitizzazione pre-elaborazione.
Prima che qualsiasi input del cliente raggiunga il motore di ragionamento principale, passa attraverso un modello locale di Named-Entity Recognition (NER) che maschera e tokenizza i PII. Inoltre, imponiamo l'affidabilità attraverso il red-teaming automatizzato dei prompt. Distribuendo script avversari durante la pipeline CI/CD per tentare attivamente di violare le istruzioni dell'agente o estrarre dati mascherati, garantiamo che l'ambiente di produzione rimanga ermeticamente protetto contro attacchi di prompt injection.
Metriche di performance dell'automazione protetta da guardrail
L'implementazione di questi guardrail di conformità non compromette la velocità operativa. Isolando le interazioni ad alto rischio per la revisione umana, il resto del flusso di Onboarding clienti viene elaborato con un'efficienza senza precedenti. Rispetto ai kickoff manuali legacy, questa architettura offre notevoli vantaggi prestazionali:
- Riduzione della latenza: I controlli di conformità automatizzati e il mascheramento dei PII vengono eseguiti in meno di 200ms per nodo, garantendo la fluidità conversazionale in tempo reale.
- Ottimizzazione delle risorse: L'intervento umano non necessario viene ridotto dell'85%, consentendo agli account manager senior di concentrarsi esclusivamente sulla costruzione di relazioni strategiche anziché sulla raccolta dati.
- Conformità a zero difetti: Il 100% dei dati sensibili viene tokenizzato prima di lasciare l'ambiente server sicuro, mantenendo un rigoroso allineamento con SOC2 e GDPR.
In definitiva, ingegnerizzare l'affidabilità significa controllare la varianza dell'AI. Incapsulando modelli probabilistici all'interno di workflow n8n deterministici, trasformiamo una tecnologia volatile in un motore di crescita prevedibile e di livello enterprise.
Espansione dei margini e ROI delle operazioni asincrone
Il passaggio da kickoff sincroni guidati da operatori umani a un'architettura asincrona guidata da agenti non è solo un upgrade operativo. Nel contesto del growth engineering del 2026, si tratta di una ristrutturazione fondamentale delle tue unit economics. Distribuendo workflow n8n per gestire l'ingestione dei dati, la mappatura degli stakeholder e la configurazione iniziale, trasformiamo un collo di bottiglia ad alto contatto in un flusso di Onboarding clienti altamente scalabile che incide direttamente sulle metriche finanziarie più critiche.
Comprimere i periodi di recupero del CAC eliminando l'OPEX
Ogni ora che un Customer Success Manager (CSM) trascorre in chiamate di kickoff manuali, inserimento dati ed email di follow-up rappresenta una tassa diretta sul tuo Customer Acquisition Cost (CAC). Quando sostituiamo questi touchpoint sincroni con operazioni asincrone guidate da LLM, il costo marginale dell'Onboarding scende quasi a zero.
Considera i dati di riferimento: l'Onboarding enterprise tradizionale richiede spesso da 15 a 20 ore lavorative per account. Applicando la tariffa oraria complessiva di un CSM, ciò aggiunge centinaia, se non migliaia, di dollari al CAC, estendendo il periodo di recupero di mesi. Instradando il flusso di Onboarding clienti attraverso un agente autonomo su n8n, eliminiamo completamente queste ore manuali. L'agente analizza il contratto firmato, estrae i metadati necessari tramite un payload JSON strutturato ed esegue il provisioning del workspace cliente tramite API in meno di 200ms. Il risultato è una drastica compressione del periodo di recupero del CAC, liberando capitale per un'aggressiva acquisizione top-of-funnel.
Accelerare il Time-to-Value (TTV) per espandere la NRR
L'espansione dei margini non riguarda solo il taglio delle spese operative; riguarda la protezione e la moltiplicazione dei ricavi. La Net Revenue Retention (NRR) dipende fortemente dalla rapidità con cui un nuovo cliente raggiunge il suo primo momento di valore ("aha moment"). L'Onboarding sincrono è intrinsecamente vincolato dalla disponibilità del calendario umano. Se il tuo specialista di implementazione è occupato per due settimane, il Time-to-Value (TTV) del cliente viene artificialmente ritardato di 14 giorni.
Gli agenti AI asincroni operano a latenza zero. Nel momento in cui un contratto viene firmato tramite Stripe o DocuSign, il Webhook attiva il layer di orchestrazione. L'agente genera immediatamente la documentazione di kickoff personalizzata, mappa i requisiti tecnici del cliente e avvia il processo di ingestione dei dati senza attendere una chiamata Zoom programmata. Questo slancio immediato riduce il rischio di churn nella fase iniziale a valori prossimi allo zero, aumentando direttamente la NRR garantendo che i clienti siano integrati nell'ecosistema del prodotto fin dal primo giorno.
La leva definitiva per la valutazione SaaS nel 2026
Nello scenario SaaS del 2026, le valutazioni del venture capital e del private equity sono rigidamente ancorate all'efficienza dei margini e alle metriche della Rule of 40. L'infrastruttura zero-touch rappresenta la leva definitiva per incrementare questi multipli perché disaccoppia la crescita dei ricavi da quella dell'organico. Non è più necessario scalare il team di Customer Success in modo lineare con l'MRR.
Per dimostrare tutto ciò a livello di board, i team di ingegneria devono colmare il divario tra l'esecuzione dei workflow e la telemetria finanziaria. Inviando i log di esecuzione di n8n direttamente nei tuoi strumenti ERP o di BI, puoi stabilire un tracciamento automatizzato del ROI che mappa i costi di calcolo rispetto alle ore lavorative risparmiate in tempo reale. Questo trasforma la tua architettura di automazione da semplice utility di backend in un asset finanziario quantificabile, dimostrando agli stakeholder che ogni kickoff automatizzato sta espandendo attivamente i margini di profitto aziendali.
Il passaggio a un flusso di Onboarding clienti zero-touch non è più un esercizio teorico; è un requisito di base per l'espansione dei margini nel 2026. I sistemi B2B che fanno affidamento su discovery call sincrone e provisioning manuale collasseranno inevitabilmente sotto il loro stesso peso operativo. Implementando agenti autonomi e routing semantico, eliminiamo il collo di bottiglia umano, comprimendo il Time-to-Value in millisecondi. Per scalare ulteriormente questa architettura e garantire la fedeltà dei dati nelle tue pipeline, esamina la tua telemetria principale eseguendo un audit delle tue pipeline server-side fondamentali. Il futuro del SaaS enterprise è headless, asincrono e spietatamente automatizzato. Esegui di conseguenza.
Memo Strategici Correlati
Tutti i Memo →Web scraping infrastructure: Engineering resilient proxy meshes and automated captcha neutralization for intent scouring
Traditional web scraping architectures are fundamentally broken. Engineering teams still deploying naive headless Puppeteer instances across static datacente...
Zero-downtime database upgrades for production SaaS: The architectural protocol
In 2026, scheduled maintenance windows are an operational admission of failure. In high-concurrency B2B SaaS, locking transactional records for even fifteen ...
Vuoi implementare questa architettura nella tua pipeline?
Evita i lunghi cicli di vendita e le infinite call di scoperta. Invia il tuo collo di bottiglia di acquisizione o conversione per una diagnosi tecnica approfondita in asincrono.